摘要
1993 年,Peter Dayan 在一篇论文中写道:"表征才是关键——用正确的方式看待问题,困难也会变得简单。"他提出的"正确方式"是:不根据状态长什么样来表征它,而是根据智能体接下来会访问哪些状态。这个被称为后继表征(Successor Representation, SR)的想法,开启了一个跨越三十年的研究纲领。2025 年,这个纲领的产物——BFM-Zero,一个 4.4 亿参数的单一神经网络——部署在真实的 Unitree G1 人形机器人上,无需任何任务特定训练,就能在零样本条件下完成动作跟踪、目标到达和奖励优化,甚至能在被踢倒后自行恢复并继续执行任务。
本文梳理这条从理论到部署的完整知识谱系:从 Dayan 的表格型 SR,到 Barreto 的后继特征与广义策略改进,到 Blier 的测度论形式化,到 Touati 和 Ollivier 的前向-后向(FB)表征,到 Cetin 的 FB-AWARE(使 FB 在离线 RL 基准上匹敌单任务 SOTA),到 Tirinzoni 的 FB-CPR 和 Li 的 BFM-Zero(真实人形机器人部署)。我们还涵盖了两个 2025–2026 年的新方向:Sikchi 等人的 ReLA/LoLA——在 BFM 潜空间中快速自适应以提升零样本策略 10–40%;以及 Jajoo 等人的 RLDP——用简单的策略无关潜动力学预测替代复杂的后继测度估计,在低覆盖数据场景中展现独特鲁棒性。
这不仅是强化学习中最完整的 theory-to-deployment 故事之一,更揭示了一个正在形成的学术辩论:BFM 的未来在于越来越复杂的后继测度建模,还是更简单、更鲁棒的替代方案?
1. 后继表征——一切的起点
标准的 TD 学习配合函数近似有一个隐患:泛化由表征的度量决定,而这个度量通常是空间的(欧氏距离)。当空间邻近不意味着时间邻近时——比如被一堵墙隔开的两个房间——泛化就会产生有害干扰。
Dayan 的洞见直接回应了这个问题 [Dayan1993]。他提出,状态
这里
SR 最优雅的理论结果是:在线性函数近似下,价值函数的权重学习退化为
更前瞻的是,Dayan 提出了两个贯穿后续三十年研究的观察:(1) 在奖励出现之前,一段"潜伏学习"阶段就可以构建有用的 SR——这预演了后来的无监督 RL;(2) 当策略在控制过程中改变时,SR 会退化——非平稳性问题至今仍未完全解决。
Dayan 在一个
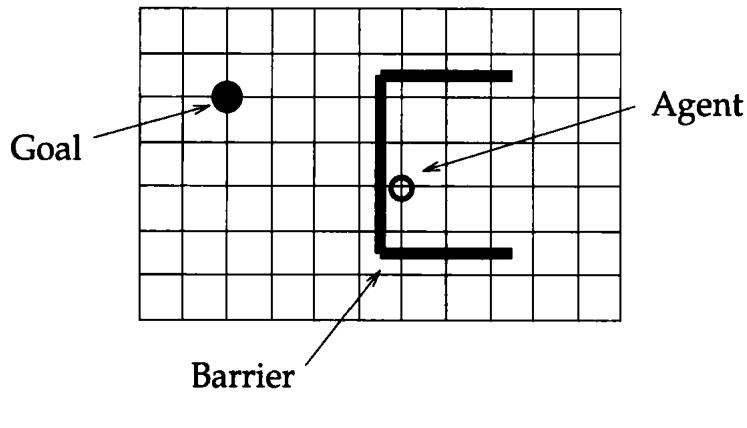
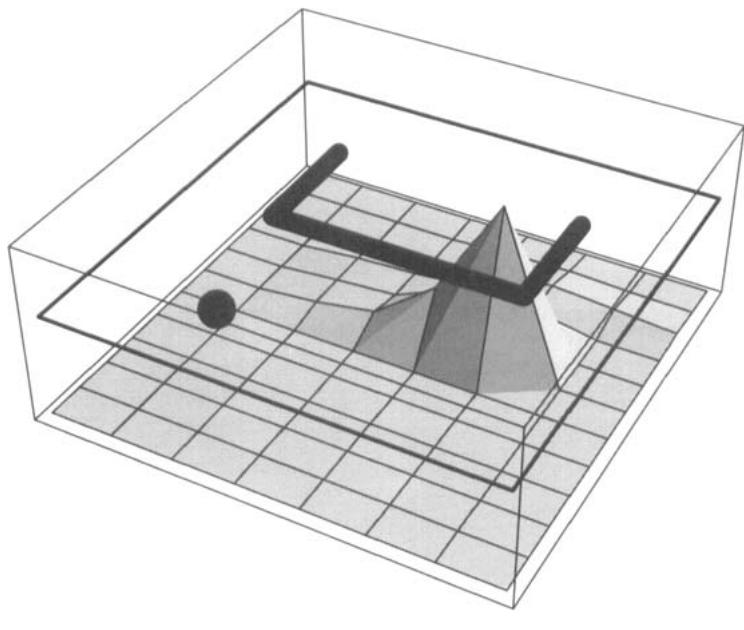
然而,Dayan 的 SR 严格限于有限表格型 MDP。如何将其推广到连续状态空间,并用它实现零样本任务迁移,成为下一个时代的关键挑战。
2. 从表征到迁移——后继特征与 GPI
Barreto 等人(2017)完成了两个关键的推广 [Barreto2017]:
第一,将离散的指示函数
在奖励线性于特征的假设下(
第二,也是最关键的贡献:广义策略改进(Generalized Policy Improvement, GPI)定理。给定一组已学到的策略
Barreto 等人证明,GPI 策略的性能下限是最佳个体策略性能减去近似误差项——甚至在智能体在新任务上执行任何动作之前,这个保证就成立了。这实质上将迁移学习重新定义为动态规划的扩展:贝尔曼最优性原理通过单一策略的最大化来改进策略,GPI 通过多个策略的最大化来实现策略改进。
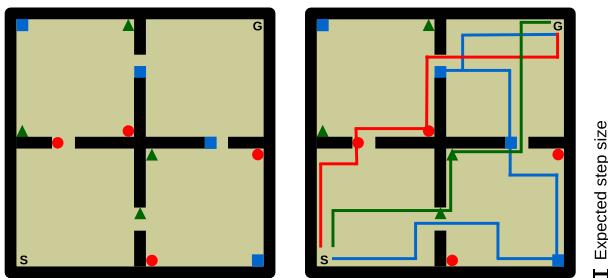
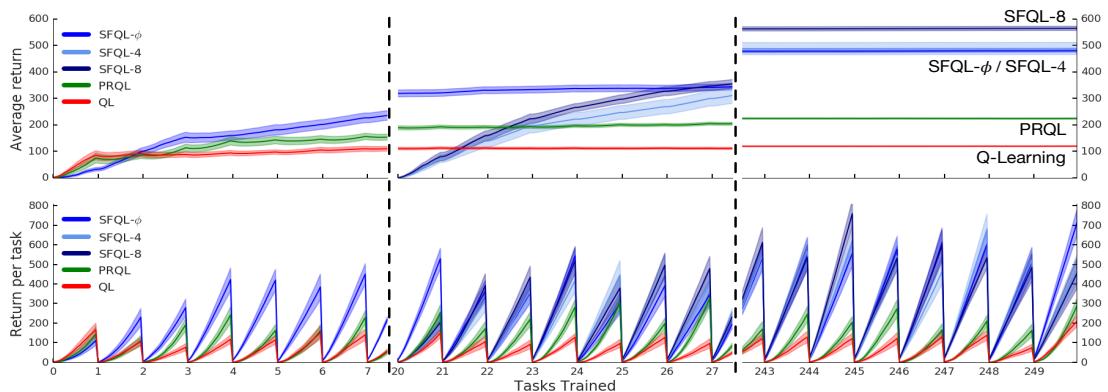
Barreto 等人(2017)在四房间导航任务上验证了 SF&GPI(图 2.1)。环境中有三类物体(不同奖励),目标在远端房间,任务奖励每 20000 步随机变化。图 2.2 的实验结果表明,所有 SFQL 变体显著优于 QL 和 PRQL——平均回报提升超过 100%。更关键的是,SFQL 在训练任务上的改进会自动泛化到未训练的测试任务,即使智能体从未在这些任务上执行过任何动作。这种泛化能力正是 GPI 定理的核心保证。
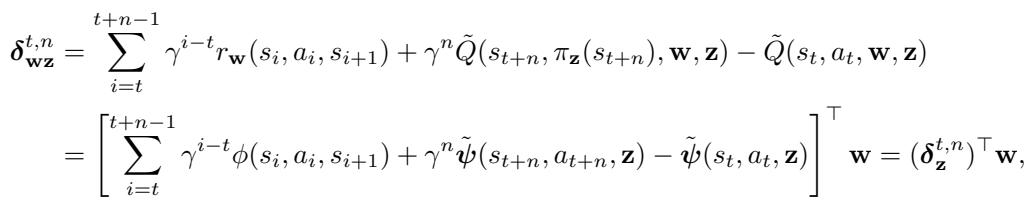
Borsa 等人(2018)进一步统一了这个框架 [Borsa2018]。他们提出通用后继特征逼近器(USFA):
SF 框架的成功也暴露了它的根本局限:一切依赖于特征
3. 数学理论的完备——作为线性算子的后继状态
Blier 等人(2021)通过将 SR 推广到一般状态空间,用测度论为这个问题提供了数学基础 [Blier2021]。他们定义后继状态算子:
后向贝尔曼方程:
贝尔曼-牛顿算子:
前向-后向(FB)分解:
图 3.1 以路径视角直观对比了这三种机制。给定观测到的转移
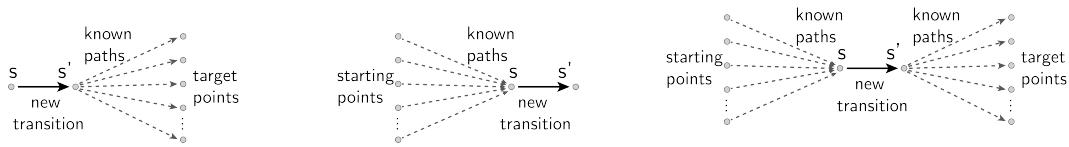
Blier 的 FB 分解是为固定策略推导的。Touati 和 Ollivier 的突破在于意识到:如果让策略本身依赖于同一个潜变量
4. FB 算法——学习一个表征,优化所有奖励
Touati 和 Ollivier(2021)提出了一个大胆的问题 [Touati2021]:能否在没有任何奖励信号的情况下,仅从环境交互中学到一个紧凑对象,使得任何事后指定的奖励函数都能从中直接读取最优策略——无需任何规划?
FB 的答案是学习两个函数
- 无监督学习阶段:从奖励无关的环境交互中学习
- 奖励编码:对于任何奖励函数
- 最优策略提取:直接使用
这就是 FB 范式的核心:
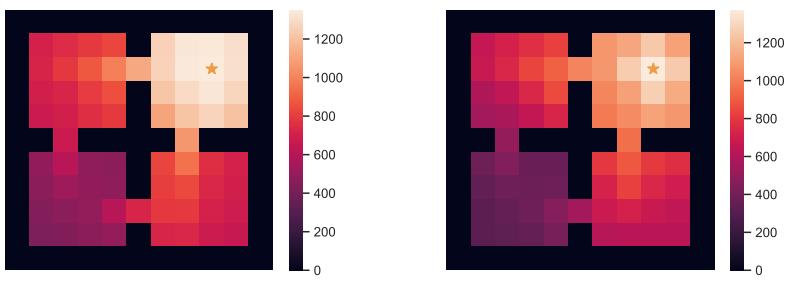
FB 的一个重要特性由图 4.1 直观展示:表示秩
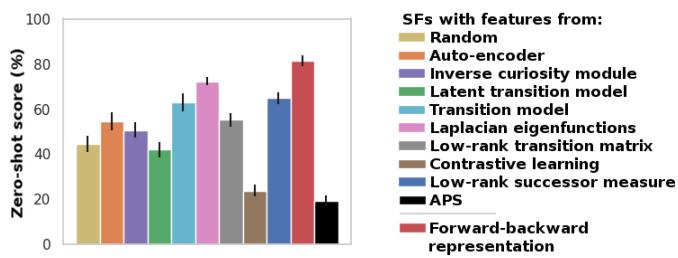
Touati 等人(2023)随后提供了系统的实证裁决 [Touati2023]。在 4 个环境、13 个任务、3 种不同探索缓冲区(RND、APS、Proto)上各 10 个随机种子的重复测试中(图 4.2):FB 达到了监督离线 TD3 性能的 81%(RND 缓冲区最佳达 85%),显著优于最佳 SF 变体(拉普拉斯特征函数,74%)。Touati 文中的箱线图进一步揭示了方法间的方差差异——FB 不仅平均性能最高,跨环境、跨缓冲区的稳定性也最好。核心发现是:大多数特征学习方法产生的特征存在有效秩坍塌——在迷宫式环境中,仅约 30% 的特征值超过阈值,而 FB 特征的谱分布均匀得多。
然而,这些结果都来自迷宫、吃豆人和简单运动任务。FB 要走向实用,还必须解决两个关键瓶颈:(1) 在标准离线 RL 基准(如 D4RL)上,原生 FB 性能几乎为零——其 TD3 式策略优化在窄行为分布数据集上遭遇严重的分布偏移;(2) FB 的任务编码
5. 让 FB 走向实用——FB-AWARE 的离线 RL 与自回归特征
离线 RL 的挑战:从零到匹敌 SOTA。 原生 FB 在 D4RL locomotion-v2 上总分仅 22.3,而单任务 SOTA 方法 XQL 达到 752.9——差距超过 30 倍。问题在于 FB 原生的 TD3 策略改进在离线数据上产生灾难性的外推误差。
FB-AWARE 的解决方案分为两部分。第一,优势加权回归(Advantage-Weighted Regression, AW):将 TD3 式策略改进替换为加权行为克隆——数据集中的动作按指数化优势加权,使用改进的加权重要性采样(IWIS)将偏差从
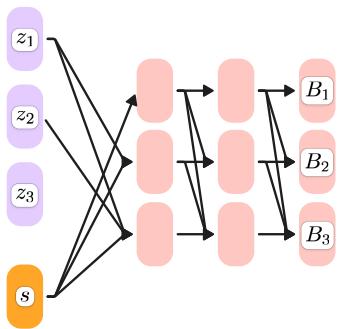
自回归特征:打破线性约束。 FB 的第二个局限源于其任务编码方式。原生 FB 中
后期的特征块以前期的任务编码为条件,使得整体任务表示
实验结果。 在 D4RL locomotion-v2 上,FB-AWARE 总分 719.5,显著缩小了与有奖励训练的单任务 SOTA 方法(XQL: 752.9, IQL: 692.6)的差距——而 FB-AWARE 始终是无奖励、零样本的通用智能体。下表展示了 D4RL 上的完整对比(节选自 Cetin2024 表1):
| 数据集 | BC | IQL | XQL | FB (原生) | FB-AW | FB-AWARE |
|---|---|---|---|---|---|---|
| halfcheetah-medium | 42.6 | 47.4 | 48.3 | 49.0 | 60.0 | 62.7 |
| hopper-medium | 52.9 | 66.3 | 74.2 | 0.9 | 59.1 | 59.9 |
| walker2d-medium | 75.3 | 78.3 | 84.2 | 0.5 | 80.5 | 89.6 |
| halfcheetah-med-replay | 36.6 | 44.2 | 45.2 | 30.8 | 52.7 | 50.8 |
| hopper-med-replay | 18.1 | 94.7 | 100.7 | 16.4 | 87.1 | 89.6 |
| walker2d-med-replay | 26.0 | 73.9 | 82.2 | 9.9 | 91.7 | 98.8 |
| halfcheetah-med-expert | 55.2 | 86.7 | 94.2 | 91.7 | 99.6 | 100.1 |
| Locomotion-v2 总计 | 466.7 | 692.6 | 752.9 | 22.3 | 696.2 | 719.5 |
原生 FB 总分仅 22.3(在 hopper-medium 上几乎为零),而 FB-AWARE 的 719.5 已接近有奖励训练的 XQL(752.9)——证明了离线 RL 技术对 BFM 训练的必要性。在 Jaco 机械臂目标到达任务上,自回归特征带来约 15% 的相对提升。在 FrankaKitchen 上,FB-AWARE(52.5/53.5)与 IQL(46.3/51.0)相当。
图 5.1 展示了自回归
在 Jaco 机械臂目标到达任务上(图 5.2),FB-AW 将原生 FB 的性能提升了一倍以上,而 FB-AWARE(4 个自回归块)在此基础上又提升了约 15%。值得注意的是,自回归特征的优势在表示维度
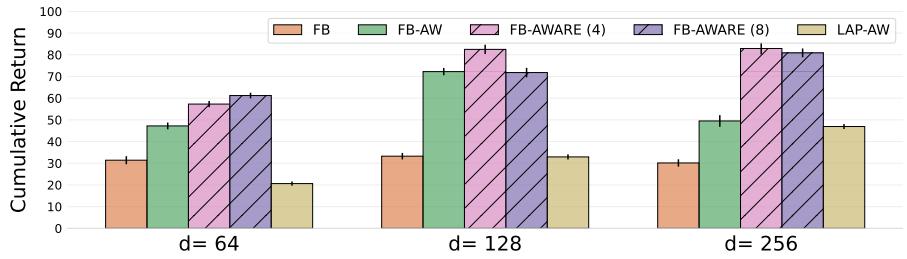
一个耐人寻味的发现: 尽管自回归特征在理论上将 FB 的表达能力从线性子空间扩展到任意非线性流形,但在大多数实验中的增益是温和的。Cetin 等人推测,BFM 的表达能力可能并非当前基准的主要瓶颈——数据质量和离线优化技术才是决定性因素。
向人形机器人迈进。 FB-AWARE 证明了通用、无奖励的 FB BFM 可以在标准离线 RL 基准上匹敌单任务 SOTA 方法。下一个问题是:FB 能否扩展到 69 维动作空间、不稳定的全身人形机器人控制?
6. 行为基础模型——FB 用于控制真实机器人
Tirinzoni 等人(2025)用 FB-CPR 给出了答案 [Tirinzoni2025]。核心挑战是:在 69 维动作空间中进行无监督 FB 探索会产生无用的、不稳定的行为。解决方案是条件策略正则化(CPR):将无标签运动捕捉轨迹嵌入潜空间(
其中
Pirotta 等人(2024)的 FB-IL 概览如图 6.1 所示。核心思想简洁而强大:所有主流模仿学习原则都可以表达为在潜空间
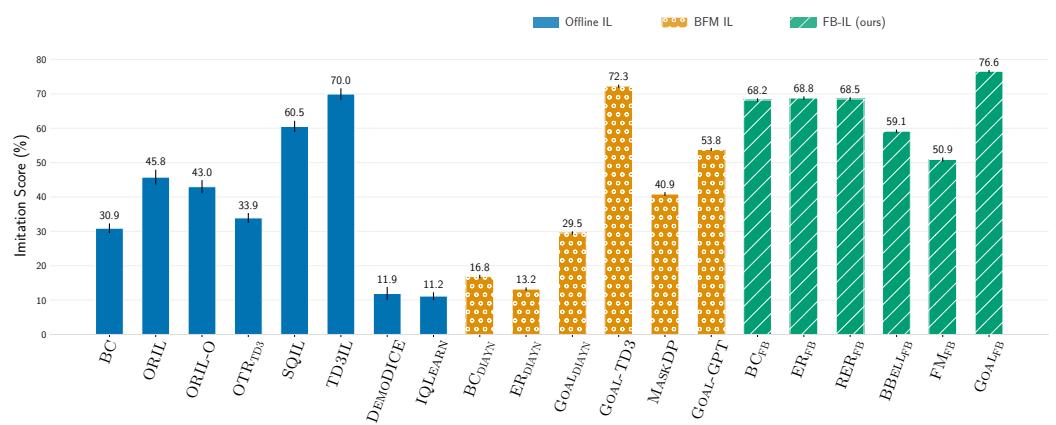
Pirotta 等人(2024)展示了 FB 的另一个维度 [Pirotta2024]:同一个预训练 FB 模型可以用来实现即时模仿学习。给定少量专家轨迹,不同的 IL 原则——行为克隆、分布匹配、贝尔曼残差最小化——都归结为在低维潜空间(
FB-CPR 的核心架构如图 6.2 所示。无标签运动捕捉轨迹通过
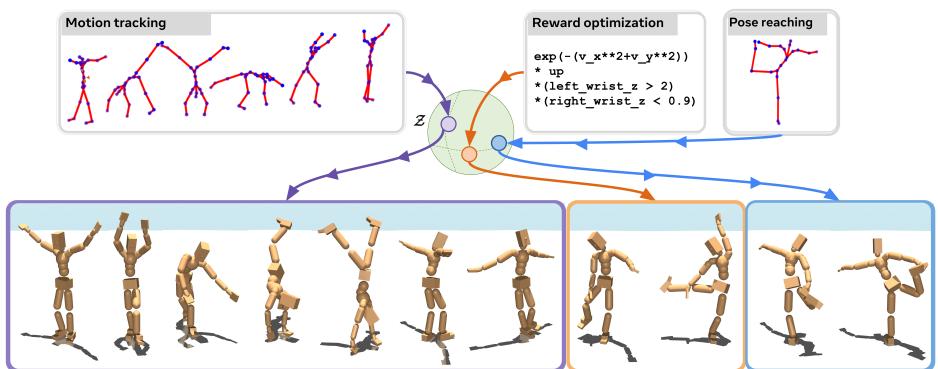
Li 等人(2025)的 BFM-Zero 是这条弧线在当下的终点 [Li2025]:将 FB-CPR 从仿真部署到真实的 Unitree G1 人形机器人。三个关键的 sim-to-real 扩展:(1) 非对称训练——Actor 接收噪声观测历史,Critic 访问特权仿真状态;(2) 大规模域随机化(质量、摩擦、关节偏移、质心偏移);(3) 辅助安全 Critic(关节限位、自碰撞、脚滑动)。图 6.3 展示了 BFM-Zero 从仿真到真实的完整 pipeline。三个关键的 sim-to-real 扩展在图中得到突出——(1) 非对称 Actor-Critic 架构:Actor 仅接收带噪声的观测历史(模拟真实传感器),而 Critic 在训练时访问特权仿真状态;(2) 广泛的域随机化覆盖质量、摩擦、关节偏移等物理参数;(3) 辅助安全 Critic 提供关节限位、自碰撞和脚滑动的惩罚信号。这些设计使得在仿真中训练的 BFM 能够零样本迁移到真实硬件上,无需任何微调。
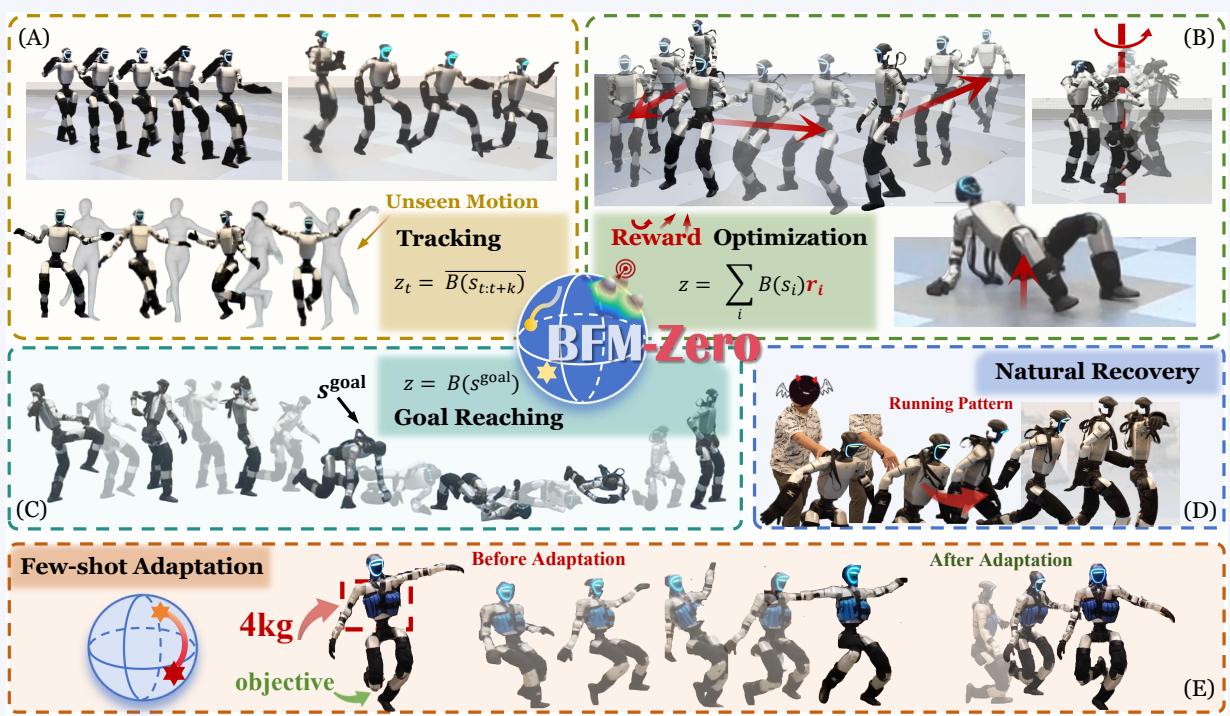
最引人注目的结果是扰动恢复:机器人被推搡、踢踹甚至拖倒在地后,能自然恢复并继续执行任务——这不是通过显式鲁棒性训练实现的,而是 FB 潜空间的结构化技能库使得策略能够灵活切换到备选行为模式。在负载 4 公斤的情况下,通过交叉熵方法(CEM)优化潜变量,单腿站立时间从不到 5 秒延长到超过 15 秒,动作跟踪误差降低 29.1%。
这几个应用的成功也让我们更清楚地看到了当前范式的边界。但还有一个实际的问题:即使是最好的 BFM,其零样本策略也是次优的——推理过程中的误差(
7. 快速自适应——从 BFM 潜空间中挖掘更好的策略
图 7.1 概括了 Sikchi 等人方法的核心直觉。任何 BFM 的无监督预训练产生了两样东西:(1) 一个策略空间
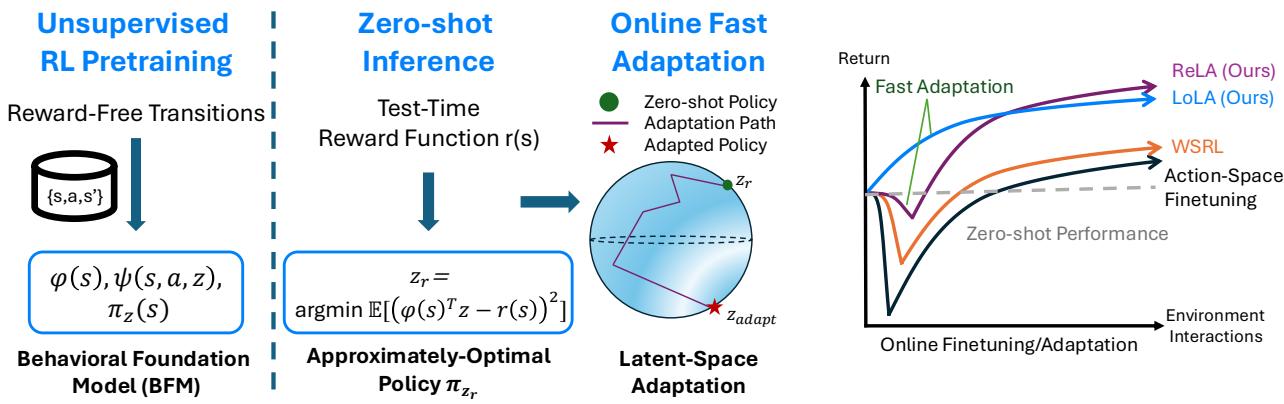
关键发现:BFM 的潜空间已经包含了比零样本推理更好的策略。 Sikchi 等人证明,FB、HILP、PSM 和 FB-CPR 四种 BFM 的潜策略空间
为什么在潜空间中搜索? 潜变量
ReLA(Residual Latent Adaptation,残差潜变量自适应):一种离策略 Actor-Critic 方法。将 Q 函数分解为冻结的 BFM 基础项加一个可学习的残差项:
残差 Critic 只需一个小型网络(2 层 MLP,64 隐藏单元 vs 完整 Critic 的 1024 单元),因为理论上它只需要修正奖励投影误差
LoLA(Lookahead Latent Adaptation,前瞻潜变量自适应):一种纯 Actor 方法,完全避开了 Critic 学习的分布偏移问题。参数化一个关于潜变量的高斯分布
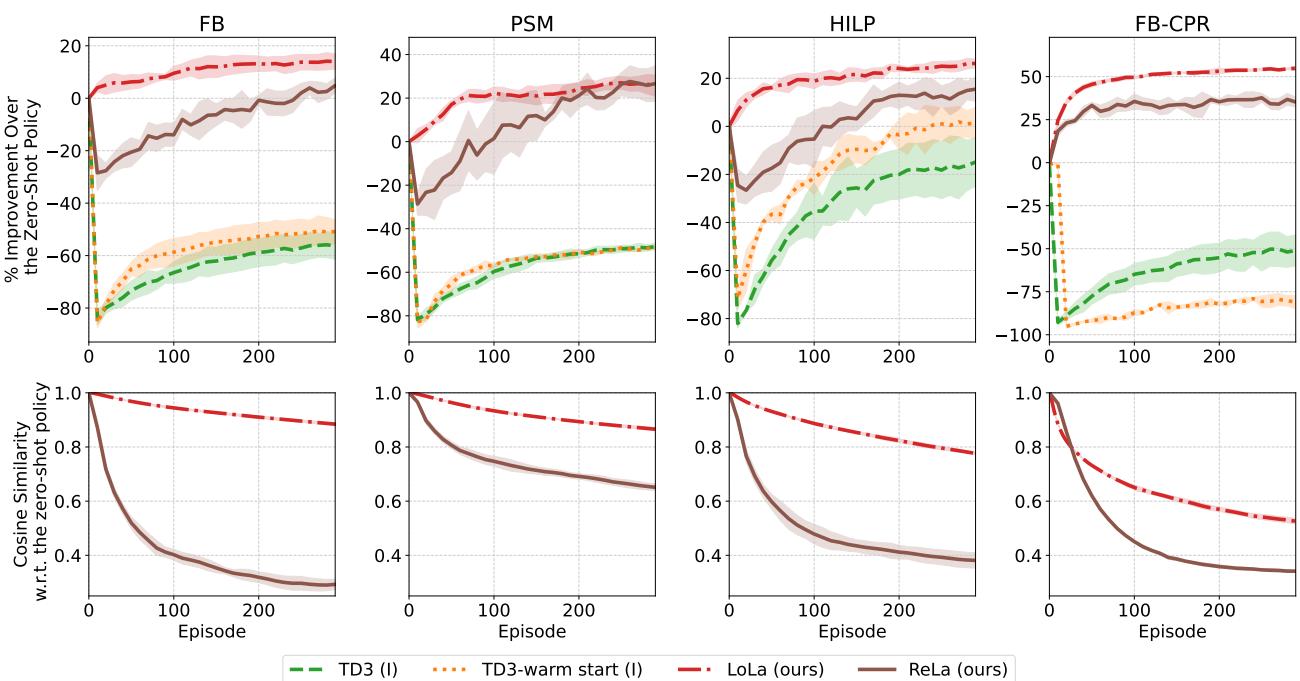
然后用 REINFORCE 配合 leave-one-out 基线估计梯度。LoLA 运行速度是 ReLA 的 157 倍(2,200 vs 14 FPS),并且实现了单调性能改进——初始性能从不下降,这在所有 BFM 和所有测试域上均成立。
实验结果。 在 4 种 BFM 和 64 个任务上,LoLA 在几十个 episode 内实现了 10–40% 的提升。在 HumEnv(45 个人形机器人任务)上,20 个 episode 内提升约 10%,200 个 episode 内提升约 40%。余弦相似度分析揭示了一个有趣的现象:ReLA 在潜空间中偏离
图 7.2 汇总了所有方法和 BFM 的聚合性能改进(上)以及潜空间中的余弦相似度变化(下)。上图的纵轴是相对于零样本策略的性能提升百分比,可以清楚看到:动作空间微调方法(TD3-I 灰色线)几乎在所有 BFM 上经历了显著的初始性能崩溃——甚至低于零样本基线。ReLA(蓝色)在部分领域(尤其是 Pointmass)也有小幅下降,但远不及动作空间方法严重。LoLA(绿色)在所有 BFM 和所有任务上实现了单调改进——曲线从不低于零。下图解释了原因:ReLA 在潜空间中偏离
一个实际启示: 在 LoLA 和 ReLA 之间,LoLA 的单调改进和计算效率(157× ReLA 的 FPS)使其成为实际部署的默认选择——前提是可以对环境进行任意状态重置(privileged resets)。这进一步强化了 Pirotta2024 的发现:BFM 潜空间的结构化特性使得在其中搜索远比微调整个模型高效。
8. 更简单的路径?——RLDP 挑战 FB 共识
BFM 的核心假设是:需要通过学习后继测度(Successor Measures)来获得好的状态表征。FB、PSM、HILP 都通过贝尔曼备份来联合优化表征和后继特征——但这也引入了自举不稳定性、需要先验指定策略/奖励类别、以及可能的外推动作查询。Jajoo 等人(2026)提出了一个挑战性的问题 [Jajoo2026]:这些复杂的表征学习目标真的是零样本 RL 所必需的吗?
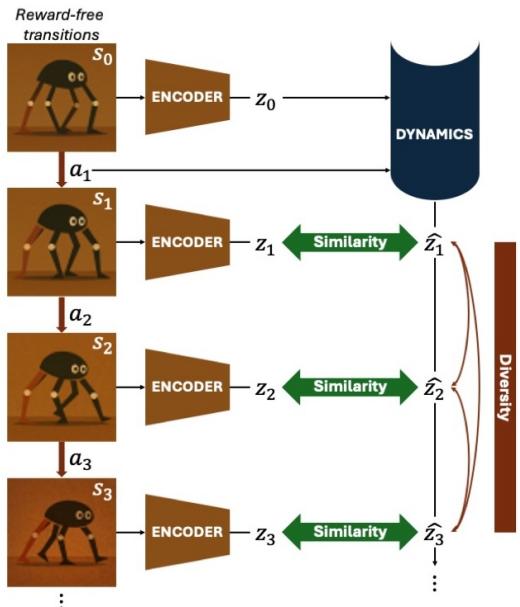
RLDP(Regularized Latent Dynamics Prediction,正则化潜动力学预测):一个两阶段的简单替代方案。
第一阶段——表征学习。 学习状态编码器
其中
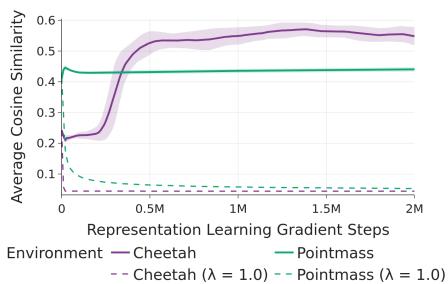
Jajoo 等人发现单纯的潜动力学预测会导致"温和特征坍塌"——状态表征的余弦相似度随训练增加,缩小了可表示奖励函数的张成空间。解决方案简单而有效:添加正交正则化:
将特征投影到超球面
理论基础。 引理 4.3 证明,最小化 RLDP 损失可以上界任何 Lipschitz 值策略的后继测度预测误差——这为为什么动力学预测特征适用于 BFM 训练提供了形式化保证。
第二阶段——BFM 训练。 冻结
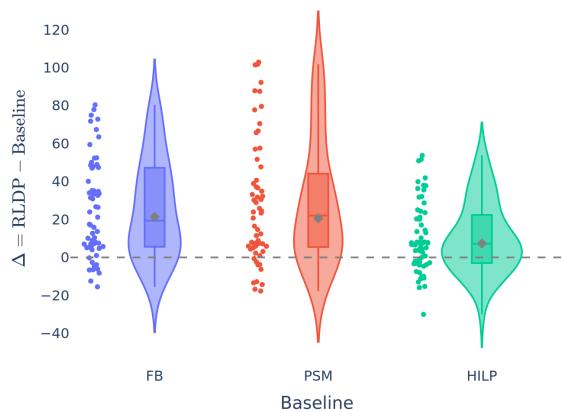
实验结果。 在标准 DMC + ExoRL 基准上,RLDP 匹敌或超越 FB、PSM 和 HILP。在 SMPL 人形机器人 45 个任务上,RLDP 与基线方法竞争力相当,部分任务甚至超越了 oracle 性能。但 RLDP 真正的优势在于低覆盖数据场景:在 D4RL medium 和 medium-expert 数据集的 6 个任务中,RLDP 在 5 个任务上超越所有基线——而基于贝尔曼备份的方法(FB、PSM、HILP)在这些低覆盖场景中表现显著更差。原因在于 RLDP 的策略无关性——它只使用数据集中实际观测到的
图 8.2 是 RLDP 论文中最具诊断性的实验结果。它展示了训练过程中随机采样状态对的平均余弦相似度变化——无正则化时(蓝色),相似度从约 0.45 单调上升至 0.55+,表明所有状态表征在趋于同质化。这种"温和坍塌"不像完全坍塌(所有表征坍缩到同一点)那样彻底——动力学预测损失仍在下降——但它系统性地缩小了可表示奖励函数的张成空间。添加
RLDP 最引人注目的结果来自低覆盖数据场景(图 8.3)。在 D4RL medium 和 medium-expert 数据集的 6 个任务上,RLDP 在 5 个任务中超越了 FB、PSM 和 HILP——每个点代表一个 (任务, 种子) 对的
范式张力。 RLDP 的提出在 BFM 领域引发了一个根本性的方法论辩论。FB 谱系认为后继测度估计是必需的;RLDP 证明策略无关的潜动力学预测可以匹敌甚至超越这些方法,尤其在低覆盖数据场景中。然而,RLDP 尚未在 FB-CPR 成功的人形机器人规模(69 维动作空间)上测试。两种方法是否可以结合——例如用 RLDP 表征替代 FB 中的联合学习
9. 开放问题与未来方向
固定动力学假设:从 Dayan1993 到 Jajoo2026,所有论文都假设环境转移动力学是平稳的 [Dayan1993, Li2025]。现实中,动力学持续变化——负载、地形、磨损。Sikchi2025 的 LoLA 提供了快速在线自适应,Li2025 的 CEM 在负载变化下降低跟踪误差 29.1%——但这些都是被动的。一个能预测或对动态变化保持不变的 BFM 仍未出现。
表征学习的范式辩论:FB 谱系认为通过贝尔曼备份学习后继测度是必需的 [Touati2021, Cetin2024, Tirinzoni2025]。Jajoo2026 的 RLDP 挑战了这一共识——证明策略无关的潜动力学预测可以匹敌甚至超越这些方法,尤其在低覆盖数据场景中表现出独特鲁棒性 [Jajoo2026]。但 RLDP 尚未在 69 维动作空间的人形机器人控制规模上测试。两种方法能否结合——例如用 RLDP 表征初始化 FB 的
推理与自适应的权衡:Sikchi2025 证明 BFM 潜空间中确实存在更好的策略,只是零样本推理找不到它们 [Sikchi2025]。Cetin2024 的自回归特征通过非线性推理部分解决了这个问题 [Cetin2024]。但最优策略是在训练时还是测试时找到更高效,仍无定论。
环境特定预训练:每个 BFM 必须为每个新机器人或环境从头训练 [Tirinzoni2025, Li2025]。Jajoo2026 的两阶段 RLDP(表征→策略)暗示了一个部分解耦的方向:如果表征可以跨环境共享,只有策略需要重新训练——但这尚未被证明。
数据质量与算法的交互:Cetin2024 的发现耐人寻味:在高品质 MOOD 数据上,优势加权是必需的;在低品质 RND 探索数据上,优势加权反而有害 [Cetin2024]。Jajoo2026 进一步证明策略无关表征在低覆盖场景中更鲁棒 [Jajoo2026]。但没有任何工作为 BFM 预训练提供数据收集的形式化指导原则。
** Scaling Law **:Li2025 报告模型和数据规模的扩展行为未被系统刻画。Tirinzoni2025 显示 2× 扩展带来单调改进。Cetin2024 表明在当前基准上数据质量比模型表达能力更重要 [Cetin2024]。FB 类 BFM 是否像 LLM 一样服从可预测的Scaling Law,以及数据质量与模型规模如何相互作用,仍是原则性的未解问题。
10. 结语
后继表征可以说是强化学习中最为成功的思想之一——不是因为它刚提出时就是实用的(Dayan 的 1993 年论文只在 11×11 的网格世界上做了实验),而是因为它识别出了一种根本的分解:动力学可以与奖励分离。
每一个代际都解决了前一代的关键局限:Dayan 引入了 SR 但受限于表格型 MDP [Dayan1993];Barreto 推广到连续空间但需要手工特征 [Barreto2017];Touati 和 Ollivier 通过联合学习
但 2025–2026 年也带来了一个挑战:Jajoo 等人的 RLDP 表明,简单的策略无关潜动力学预测可以匹敌甚至超越整个 FB 谱系赖以建立的复杂后继测度机制——尤其在贝尔曼备份失效的低覆盖场景中 [Jajoo2026]。这构成了领域内一个健康的学术张力:BFM 的未来在于越来越复杂的后继测度建模,还是更简单、更鲁棒的替代方案?
如果过去三十年的方法论有任何启示,那就是:下一个突破将来自用"正确的方式"看待问题——一种在事后让困难看起来微不足道的方式。而那个"正确的方式"是后继测度、潜动力学、还是尚未被想象的东西,正是接下来十年的核心问题。正如 Dayan 在 1993 年所写:"表征才是关键。"
参考文献
- [Dayan1993] Dayan, P. (1993). Improving Generalization for Temporal Difference Learning: The Successor Representation. Neural Computation, 5(4), 613–624.
- [Barreto2017] Barreto, A., Dabney, W., Munos, R., Hunt, J. J., Schaul, T., van Hasselt, H., & Silver, D. (2017). Successor Features for Transfer in Reinforcement Learning. NeurIPS.
- [Borsa2018] Borsa, D., Barreto, A., Quan, J., Mankowitz, D., Munos, R., van Hasselt, H., Silver, D., & Schaul, T. (2018). Universal Successor Features Approximators. ICML 2018.
- [Blier2021] Blier, L., Tallec, C., & Ollivier, Y. (2021). Learning Successor States and Goal-Dependent Values: A Mathematical Viewpoint. arXiv preprint.
- [Touati2021] Touati, A., & Ollivier, Y. (2021). Learning One Representation to Optimize All Rewards. NeurIPS 2021.
- [Touati2023] Touati, A., Rapin, J., & Ollivier, Y. (2023). Does Zero-Shot Reinforcement Learning Exist? ICLR 2023.
- [Pirotta2024] Pirotta, M., Tirinzoni, A., Touati, A., Lazaric, A., & Ollivier, Y. (2024). Fast Imitation via Behavior Foundation Models. ICLR 2024.
- [Tirinzoni2025] Tirinzoni, A., Touati, A., Farebrother, J., Guzek, M., Kanervisto, A., Xu, Y., Lazaric, A., & Pirotta, M. (2025). Zero-Shot Whole-Body Humanoid Control via Behavioral Foundation Models. ICLR 2025.
- [Li2025] Li, Y., Luo, Z., Zhang, T., Dai, C., Tirinzoni, A., Kanervisto, A., Weng, H., Kitani, K., Guzek, M., Touati, A., Lazaric, A., Pirotta, M., & Shi, G. (2025). BFM-Zero: A Promptable Behavioral Foundation Model for Humanoid Control Using Unsupervised Reinforcement Learning. arXiv preprint / under review.
- [Cetin2024] Cetin, E., Touati, A., & Ollivier, Y. (2024). Finer Behavioral Foundation Models via Auto-Regressive Features and Advantage Weighting. arXiv preprint.
- [Sikchi2025] Sikchi, H., Tirinzoni, A., Touati, A., Xu, Y., Kanervisto, A., Niekum, S., Zhang, A., Lazaric, A., & Pirotta, M. (2025). Fast Adaptation with Behavioral Foundation Models. arXiv preprint.
- [Jajoo2026] Jajoo, P., Sikchi, H., Agarwal, S., Zhang, A., Niekum, S., & White, M. (2026). Regularized Latent Dynamics Prediction is a Strong Baseline for Behavioral Foundation Models. arXiv preprint.