十六篇论文,五条技术路线,一个通用方程
摘要: 人形机器人在家庭、医院、办公室等人类环境中部署时,面临一个共同的控制挑战:它需要既施加精确的接触力(擦拭白板、开启柜门),又在碰撞时柔顺退让(避免损坏物体或伤害人类)。实现这一切的前提,是机器人必须同时感知和控制"力"与"位置"——即力位混合控制。然而,力传感器成本高、易损坏、难以覆盖多接触点,使得"无力传感器的力估计"成为该领域的核心基础设施。本文梳理 2024–2026 年力位混合控制从分治走向统一的技术演进,聚焦三条核心脉络:(1) 阻抗方程
1. 为什么人形机器人需要力位混合控制
人形机器人区别于固定基座机械臂的本质特征在于:浮动基座、高重心、多接触、强欠驱动。这些特征使得纯粹的位置控制策略在大量真实场景中失效。
考虑三个典型任务。擦拭白板:末端执行器必须维持稳定的法向接触力——太轻无法擦除字迹,太重可能损坏板面或机器人关节。开启按压式柜门:柜门触发机构的行程仅约 3 mm,视觉几乎无法察觉;机器人必须感知到反作用力的建立,并持续施力直至机构触发。人机物理交互:当操作者推动机器人手臂进行示教时,机器人必须以可预测的柔顺性退让,而非用最大力矩抵抗。
这些任务的共同需求是:同时控制位置和力。
经典机器人学早在四十年前就给出了理论框架。Raibert 与 Craig (1981) 提出混合位置/力控制 [Raibert1981],将任务空间分解为位置控制子空间和力控制子空间。Hogan (1984) 提出阻抗控制 [Hogan1984],不直接控制力或位置,而是调节二者之间的动态关系:
这一公式奠定了此后四十年力位混合控制的理论基石。然而,经典方法面临三个现实瓶颈:(1) 需要精确的机器人动力学模型,而人形机器人的模型辨识极为困难;(2) 依赖力/力矩传感器,这类传感器成本高、信噪比低、在冲击下易损坏,且难以覆盖所有可能的接触点;(3) 多接触场景下力分布存在冗余零空间,启发式的单效应器导纳方案 [Kajita2010, Murooka2022] 无法协调全身力分配。
转折点出现在 2024 年。Portela 等人 [Portela2024] 在 CoRL 2024 上首次证明:强化学习(RL)策略可以在不使用任何力传感器的条件下,仅凭关节编码器和 IMU 等本体感知信号,学习在四足机械臂上施加精确的末端力(误差 5–10 N)。这一工作开启了"学习型力位混合控制"的研究浪潮。在随后的 18 个月里,该方向经历了从"分治"到"统一"的快速演进,并在 2025–2026 年迎来了人形机器人上的集中爆发。
2. 一个方程统一一切:从模式切换到连续柔顺
2024 至 2025 年间,力位混合控制的控制接口经历了三次关键抽象升级。理解这三次跳跃,就理解了该领域在方法论上的核心进展。
2.1 Portela2024 —— 破冰:首次学习型全身力控制
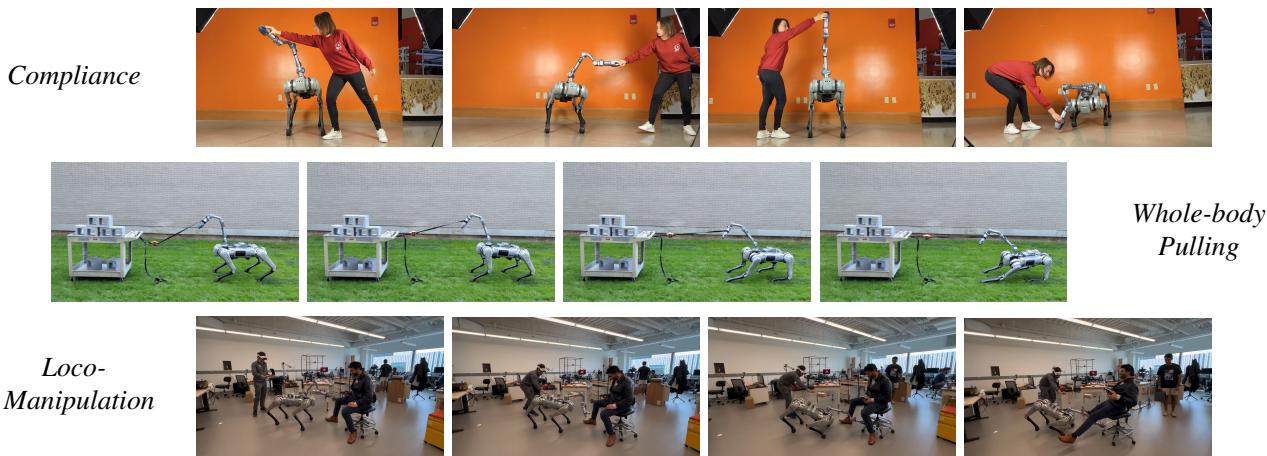
图:Portela 等人的全身力控制策略。上:柔顺交互;中:全身力施加;下:阻抗控制遥操作。[Portela2024]
Portela 等人 [Portela2024] 在 Unitree B1 四足 + Z1 机械臂平台上训练了一个 PPO 策略。该策略接收四类命令:末端位置
力训练的关键创新在于:仿真中不建模真实接触几何,而是用一个弹簧-阻尼势场
实验结果具有标志性意义:力跟踪误差 5–10 N,全身协调将工作空间体积扩大 59%,最大拉力 90 N(远超机械臂额定载荷 36 N)。通过将末端力命令设为零,策略展现出重力补偿的柔顺模式——操作者可以像摆动物理弹簧一样拖动机器人手臂。
但该方法的局限同样明显:用户必须在位置模式和力模式之间显式切换。这意味着策略无法在擦拭白板时同时跟踪运动方向和调节法向力——而这恰恰是混合力位控制的经典需求。
2.2 Zhi2025 —— 统一:一个方程,四种模式
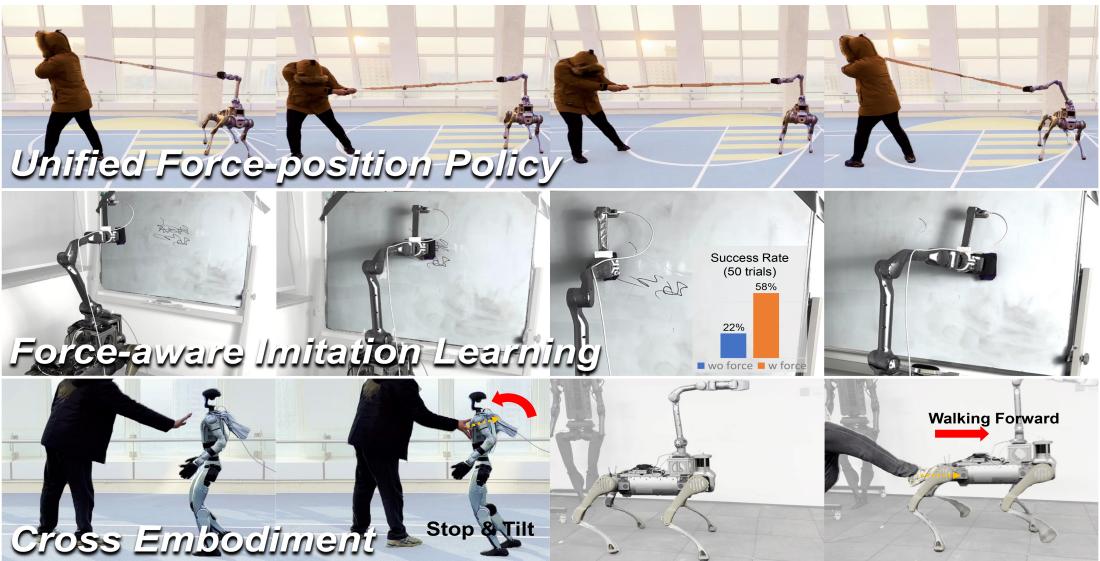
图:Zhi 等人的统一力位策略。上:力位控制行为(位置跟踪、力施加、柔顺交互);中:力感知模仿学习;下:四足与人形机器人验证。[Zhi2025]
Zhi 等人 [Zhi2025] 在 CoRL 2025 上的工作从根本上解决了模式切换问题。他们的核心洞察是:所有控制模式——位置控制、力控制、阻抗控制、混合力位控制——都可以从一个阻抗控制框架中导出。
给定位置命令
这一简洁的公式统一了四种基本行为:
- 位置控制:
- 力控制:
- 阻抗控制:仅受外力
- 混合力位控制:沿运动切向跟踪位置,沿法向施加力命令
该公式同样被推广到基座速度控制:
Zhi 等人的策略在 Unitree B2-Z1 四足机械臂和 Unitree G1 人形机器人上均完成了验证——这是该方向首次交叉形态部署。更关键的是,他们展示了力信息对模仿学习的价值:用策略内置的力估计器采集力感知示教数据,训练扩散策略(Diffusion Policy),在擦拭白板、开启/关闭柜门、遮挡抽屉四项任务上将成功率平均提升 39.5%(0.22 → 0.58, 0.36 → 0.70, 0.30 → 0.72, 0.30 → 0.76)。在视觉被遮挡的抽屉任务中,纯视觉基线成功率仅 0.30,加入力估计后提升至 0.76——充分证明了力信息在视觉退化场景中的不可替代性。
2.3 FACET2025 —— 连续:柔顺成为一个"旋钮"
FACET [Xu2025] 将抽象层级再推进一步:控制接口不再是力/位置命令,而是阻抗参数本身——
技术上的关键贡献是混合时间尺度的参考目标积分:
通过混合开环(仅设置点)、闭环(完全阻抗)和中等积分尺度,FACET 在柔顺性和跟踪稳定性之间找到了平衡点。实验验证跨越三种形态(Unitree Go2 四足、G1 人形、B1+Z1 机械臂),在柔顺模式下实现 80% 碰撞冲量降低,并承受 200 Ns 的外部冲量而不失稳。
2.4 三次跳跃的逻辑
回顾 18 个月的演进:控制接口从"两个按钮"→"一个方程"→"一个旋钮"。每次抽象都降低了复杂度维度,同时增强了功能表达能力。这一演进的核心推动力是阻抗控制公式的通用性——同一个
3. 不用力传感器,如何"感知"力?
力位混合控制的前提是获取力信息。既然不依赖力传感器,力估计的质量就成为整个系统的精度天花板。现有方法可以分为五条技术路线。
3.1 路线一:MLP 状态估计器(Portela → Zhi → FACET)
这是学习型力控的主流方案。在 RL 训练循环中,策略包含一个 MLP 状态估计器,从观测历史
这一方案的优势在于简洁:与 RL 训练无缝衔接,不需要额外的网络设计或物理知识。Zhi 等人 [Zhi2025] 的估计器还同时预测末端位置和基座速度,实现了"世界坐标系下的末端位置估计",使策略能在工作空间边界处自然触发全身协调行为。
然而,纯 MLP 估计存在精度天花板。Portela 和 Zhi 均报告 5–10 N 的估计误差,且 Sim-to-Real gap 显著——真实硬件上的力估计在 Y 轴方向的偏差尤为突出。部分原因是 MLP 缺乏物理一致性约束:它学到的可能是"关节角度模式 → 力"的统计相关性,而非因果的动力学关系,因此在训练分布外泛化能力有限。
3.2 路线二:物理信息约束(QuietWalk)
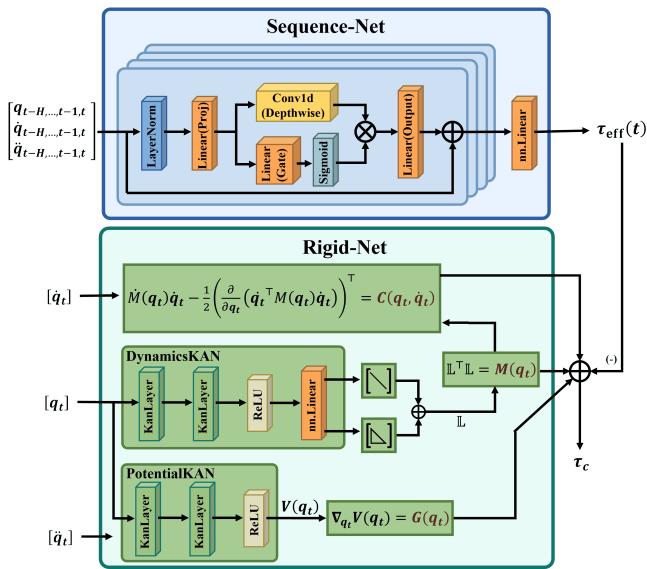
图:QuietWalk 的 PINN 架构。DynamicsKAN 学习
QuietWalk [Hu2026] 代表了力估计的另一极:用物理信息神经网络(PINN)将逆动力学一致性嵌入损失函数,从根本上改变估计的可靠性。
其 GRF 预测器的核心设计如下。输入为本体感知历史
训练损失联合优化四项:
其中
这些结果确立了一个重要原则:数据驱动可以捕捉力的模式,但只有物理约束能保证力的精度。两者缺一不可。
3.3 路线三:分析模型 + 互补滤波(SEIKO)
SEIKO [Rouxel2024] 代表了模型驱动路线。其核心思想是:真实的关节位置控制并非绝对刚性——结构弯曲和 PD 控制的内部阻抗产生了可建模的柔性。将每个关节显式建模为弹簧
该方法的优势在于计算效率极高、有清晰的物理语义、且鲁棒性好(对模型误差不敏感,因为 QP 只依赖导数的近似方向)。局限在于准静态假设限制了其对动态运动的适用性。
3.4 路线四:动力学结构网络(ABD-NET)
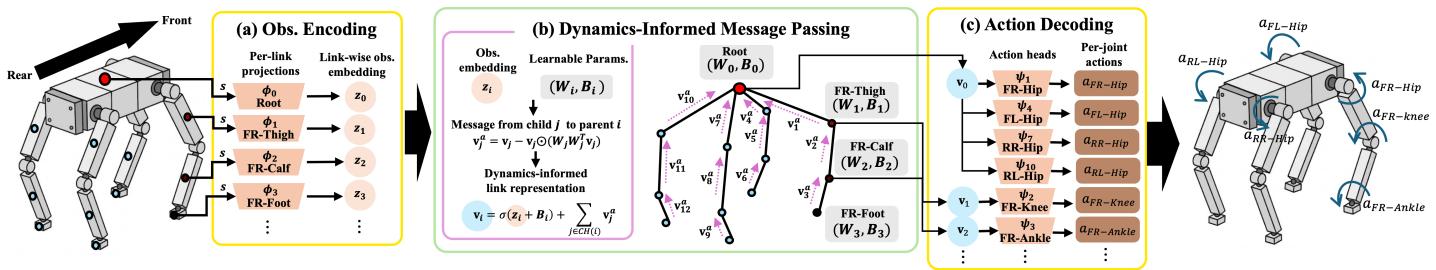
图:ABD-NET 在四足机器人上的架构示意。(a) 逐连杆观测编码;(b) 动力学信息传递(叶到根,模仿 ABA 惯性聚合);(c) 动作解码。[Shin2026]
ABD-NET [Shin2026] 从网络架构层面提供了一种全新思路:不显式估计力,而是让策略网络本身的结构反映前向动力学的计算图。具体地,采用 Articulated Body Algorithm (ABA) 的叶到根惯性传播模式:每个连杆
3.5 路线五:CFM 生成式概率推断(SixthSense)
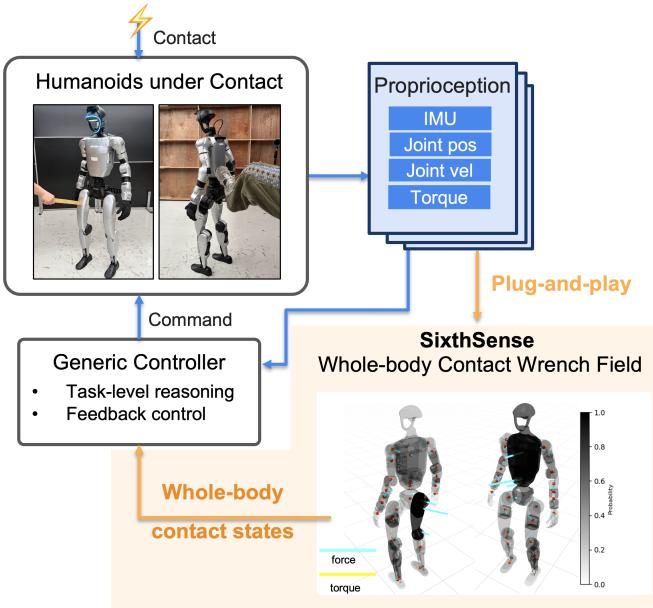
图:SixthSense 概念总览。通过本体感知推断全身接触力场,为下游控制和决策提供通用感知基础。[Chen2026]
前四条路线有一个共同局限:它们仅处理足底接触(QuietWalk/ABD-NET)、已知末端接触(MLP 估计器/SEIKO),或间接建模力而非直接估计(ABD-NET)。Chen 等人的 SixthSense [Chen2026] 提出了一条全新路线:将全身力估计建模为生成式概率推断问题,输出机器人表面所有 30 个连杆的概率接触掩码和六维力/力矩。
核心方法。SixthSense 将机器人表面离散化为 N 个子区域(Unitree G1 上 N=30),每步预测接触掩码
关键创新在于使用**条件流匹配(Conditional Flow Matching, CFM)**替代确定性回归。CFM 学习一个时变速度场
其中
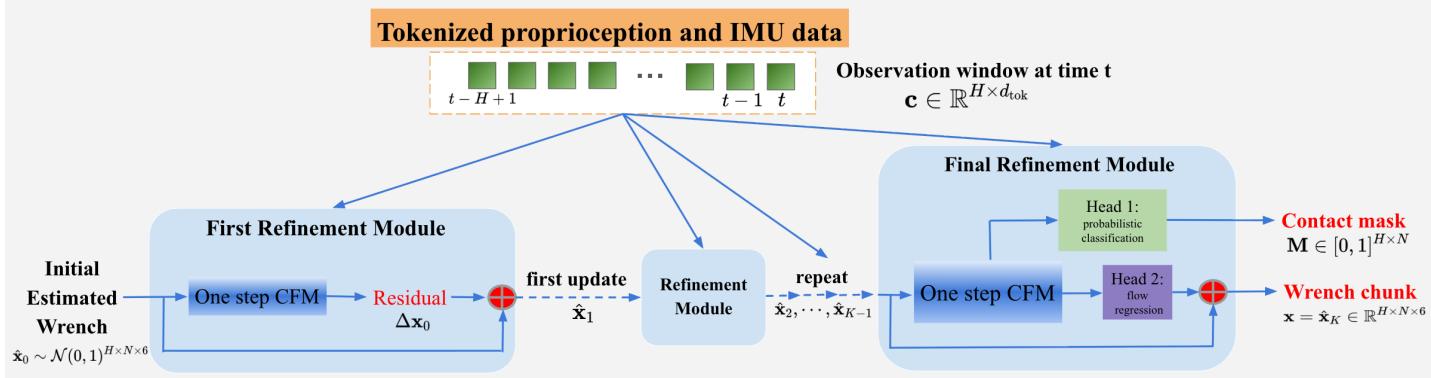
图:SixthSense 架构。CFM 主干 + 双头解码器(接触掩码头 + 力场头),从本体感知观测窗口渐进推断全身接触掩码和外部力场。[Chen2026]
模型采用共享主干 + 双头解码器设计:一个 CFM 编码器捕获共享的接触语义,两个轻量注意力头分别解码接触概率和力场。训练损失联合优化四项:
框架还包含一个深刻洞察:控制器鲁棒性决定接触可观测性。接触鲁棒的策略(通过域随机化训练)对外部扰动的本体感知响应更一致、信息量更大——反之,不鲁棒的策略产生的数据在训练力估计器时会导致更高的误报率。消融实验定量验证了这一双向耦合。
关键结果。在 Unitree G1 上的实验覆盖站立、行走和全身运动跟踪三类任务。力估计精度:大小误差 1.7–2.1 N,方向误差 17–29°,力矩大小误差 0.3–0.7 N·m(表见 3.6 节)。接触检测:站立下检测率 84.2% 且误报仅 0.4%,±0.1s 时间容差下命中率 85–98%。
最令人印象深刻的发现是零样本多点接触泛化。仅在单点接触数据上训练的 CFM 模型,在多点同时接触场景下检测率达 89.3%——而同等容量的确定性 MLP 骤降至 17.2%。MLP 在单点接触上可达 99.7% 的检测率,但在多点模糊下完全崩溃,因为其确定性映射无法表示多模态后验。CFM 通过基于流的采样自然维护多样假设。与模型基方法(GMO [Haddadin2017]、CPF [Manuelli2016])的对比同样突出:CPF 的误报率随接触点数指数增长(5 点时达 85.8%),SixthSense 仅 17.0%。
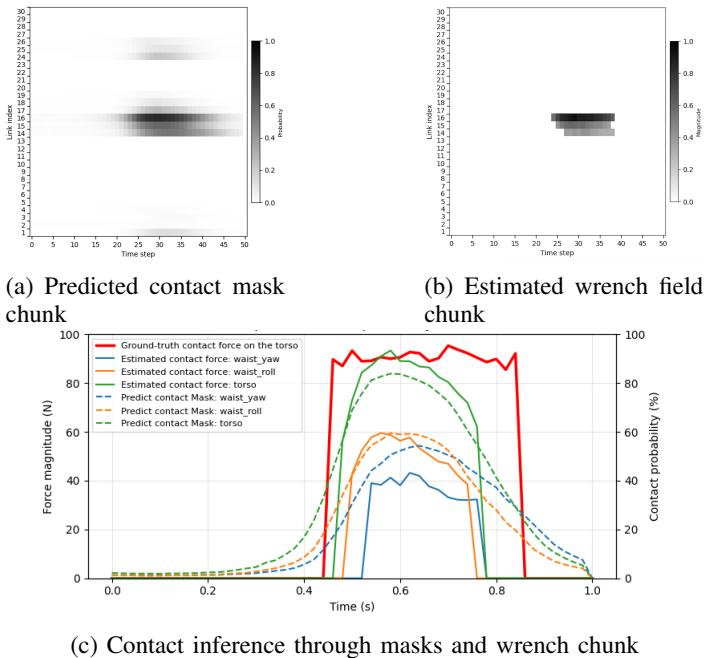
图:真实 Unitree G1 上的接触力场估计。(a) 预测接触掩码 M ∈ [0,1]^{50×30};(b) 预测力场量级 ‖W‖;(c) 最终估计的接触位置和力大小。[Chen2026]
在五条路线中的定位。SixthSense 是唯一实现全身多点力估计的路线。其概率输出天然提供不确定性量化,适合与贝叶斯决策或风险感知 MPC 结合。主要局限是推理延迟(~500ms vs MLP 的 <1ms)和连杆级空间分辨率。将 CFM 条件从纯本体感知扩展到视觉、语言等模态,并加速推理至实时水平,是该路线的关键下一步。
3.6 五条路线的精度光谱
| 方法 | 力估计精度 | 物理一致性 | 计算开销 | 适用场景 |
|---|---|---|---|---|
| MLP 状态估计 | 5–10 N | 无保证 | 低(推理内嵌 RL) | 粗粒度操作 |
| PINN + 逆动力学 |
|
强(动力学残差约束) | 中(离线训练 + 冻结推理) | 精密力控、安全关键 |
| 关节柔性 + QP | 依赖模型精度 | 强(显式物理模型) | 极低(0.4 ms/QP) | 准静态多接触 |
| 动力学结构 GNN | 不直接估计力 | 中等(软正则化) | 中(GNN 推理) | 策略学习效率提升 |
| CFM 生成式 | 1.7–2.1 N(大小) | 中等(CFM 收敛隐式约束) | 较高(~500ms/步) | 全身多点感知、pHRI |
目前尚未出现将这五条路线的优势结合的工作——例如用 PINN 级精度的力估计器为 RL 策略提供奖励信号(QuietWalk 已做到),同时用 CFM 的全身感知覆盖非足底接触(SixthSense 已做到),再让策略网络采用 ABD-NET 式的动力学结构(三者的融合将产生一个既精确又全面的力感知 + 力控制框架)。
4. 应用一 —— 柔顺交互:从刚性跟踪到可控柔顺
力估计是实现柔顺控制的基础设施。在 2025 年,该方向出现了两种形成鲜明对比的技术方案。
4.1 SoftMimic —— 从示例中学习柔顺
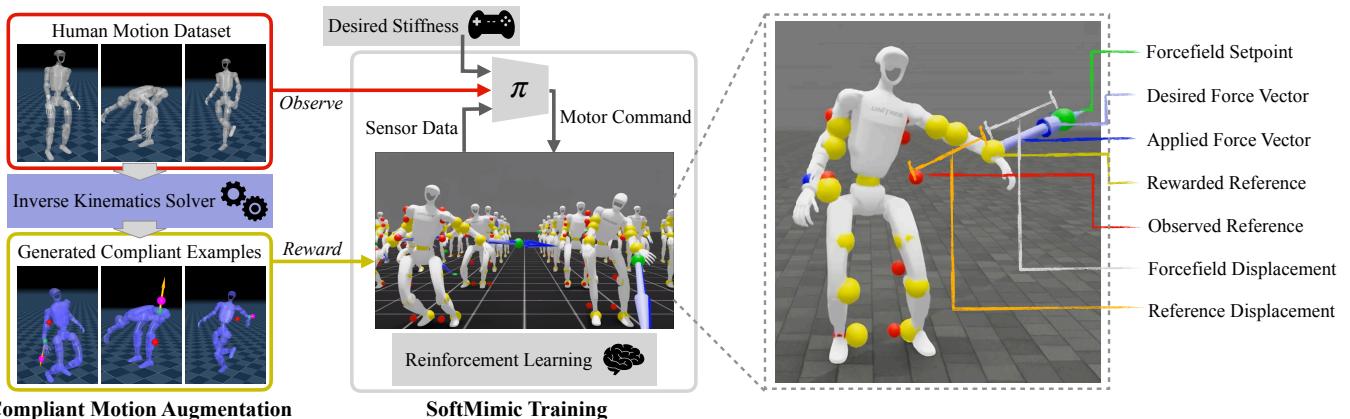
图:SoftMimic 的柔顺全身控制框架。左:离线 IK 求解器从原始参考运动和外力/刚度参数生成增强柔顺数据集
Margolis 等人 [Margolis2025] 的 SoftMimic 解决了一个具体问题:基于 RL 的人形运动跟踪策略天然是"僵硬"的——任何偏离参考运动的偏差都被奖励函数视为需强行纠正的误差,导致机器人在意外接触时施加不受控制的巨大力量。
SoftMimic 的方案分两步。第一步,柔顺运动增强(CMA):使用微分 IK 求解器离线生成一个增强数据集
这一设计的关键洞察是:策略的柔顺程度由高层激励(奖励函数)决定,而非底层 PD 增益。即便使用固定的中等 PD 增益,策略也能通过有意制造位置误差来调节力输出。SoftMimic 在 Unitree G1 上实现了 40–1000 N/m 的刚度范围,验证了站立、行走、取物、倒水、跳舞等动作的可控柔顺。以同一段 20 cm 箱子抓取动作为参考,策略成功泛化到不同宽度的箱子,并始终保持一致的轻柔挤压力。
4.2 CHIP —— 后见之明:一行修改,无需增强
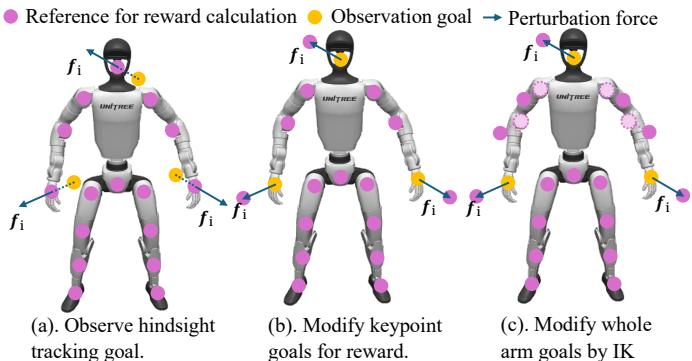
图:三种柔顺跟踪策略训练方案对比。(a) CHIP —— 修改输入空间中的稀疏跟踪目标(后见扰动),奖励基于原始参考计算;(b) GentleHumanoid —— 修改奖励计算中的关键点目标;(c) SoftMimic —— 编辑完整运动学参考轨迹以考虑末端扰动。[Chen2025]
CHIP [Chen2025](NVIDIA)以一种优雅的方式将 SoftMimic 的复杂度大幅降低。其核心洞察来自对训练过程的重新审视:
- SoftMimic 的做法:修改参考运动
- CHIP 的做法:修改跟踪目标
具体地,训练时在末端施加随机扰动力
这一方法的最大优势是可扩展性:不需要离线 IK 求解器、不需要为每个运动片段生成增强数据、不需要修改奖励函数。它作为即插即用模块可直接集成到任何基于关键点的运动跟踪框架中。CHIP 在擦拭、开门、搬运箱子、推车、书写等任务上保持了与 SoftMimic 相当的柔顺控制质量,同时支持多机器人协同抓取(全局 3 点跟踪 + 柔顺抓取规划)。
4.3 两种范式的启示
SoftMimic 和 CHIP 代表了数据驱动柔顺控制的两种哲学:离线精心准备 vs 在线智能扰动。前者用计算换精度,后者用设计换效率。从实践角度看,CHIP 的可扩展性优势使其更可能成为未来大规模运动数据集上训练柔顺人形策略的默认方案。
5. 应用二 —— 静音行走:力感知驱动的低噪声运动
足地冲击是人形和四足机器人在室内部署时的主要噪声源。QuietWalk [Hu2026] 和 MUTE [Cao2025] 从不同精度层次解决了这一问题,它们之间的对比清晰地展示了"从运动学代理到动力学直接建模"的升级路径。
5.1 MUTE —— 运动学代理方案
MUTE [Cao2025] 在 Unitree Go1 四足机器人上引入了"安静因子"
然而,惩罚足端速度是一种间接代理:它假设低接触速度必定意味着低冲击力。这一假设在某些情况下成立,但并不精确——快速的轻触和慢速的重踏可能产生完全不同的力和噪声,而速度代理无法区分。
5.2 QuietWalk —— 物理信息直接方案
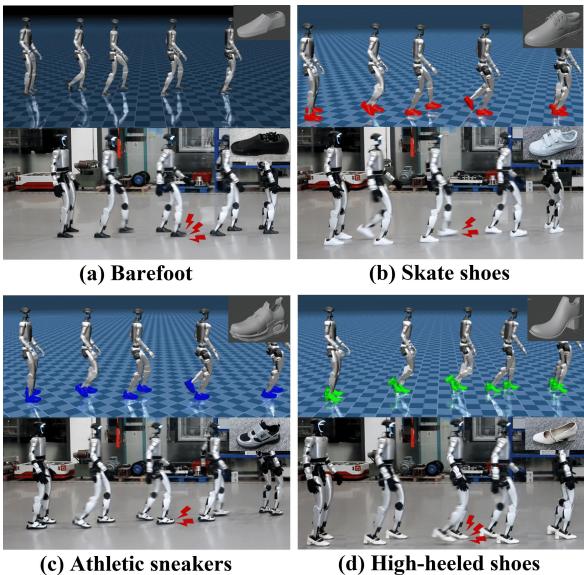
图:QuietWalk 在仿真和真实 Unitree G1 人形机器人上的跨鞋具验证:barefoot、滑板鞋、运动鞋、高跟鞋。[Hu2026]
QuietWalk [Hu2026] 用其 PINN GRF 预测器替代了速度代理。具体地,将冻结的 GRF 预测器作为 RL 训练回路中的"物理奖励评判器",直接惩罚预测的冲击力:
在 Unitree G1 人形机器人上以 1.2 m/s 行走(barefoot,四种地面平均),QuietWalk 实现平均噪声级(MNL)降低 7.17 dB(89.47 → 82.30 dBA),峰值噪声级(PNL)降低 4.98 dB。降噪效果具有表面依赖性——在混凝土和地毯上改善更大,在木地板和瑜伽垫上改善较小(后者本身具有更高的阻尼)。
更重要的发现来自跨鞋具实验。QuietWalk 系统性测试了 barefoot、滑板鞋、运动鞋和高跟鞋四种条件在四种地面上的噪声表现。结果显示:高缓冲/高阻尼的鞋具(滑板鞋、运动鞋)趋于降低噪声,而高跟鞋由于高接触刚度和短接触时间显著增加噪声——最不利组合(高跟鞋 × 木地板)与最有利组合(运动鞋 × 瑜伽垫)之间的噪声差异接近 20 dB。这一量级差异说明鞋具-地面的接触动力学是静音行走的关键变量,而当前的力控策略在高刚度/低阻尼接触条件下仍面临挑战。
5.3 从代理到直接建模
MUTE(脚速惩罚)和 QuietWalk(GRF 直接惩罚)之间的演进,是力位混合控制领域中一个具有普遍意义的范式跃迁:运动学代理只能间接逼近力的效果,而物理信息力估计能直接优化力的本身。QuietWalk 的消融实验有力地支持了这一观点——一旦移除逆动力学约束,GRF 预测的
6. 前沿 —— 力自适应与极端工况
6.1 极端力扰动下的全身控制
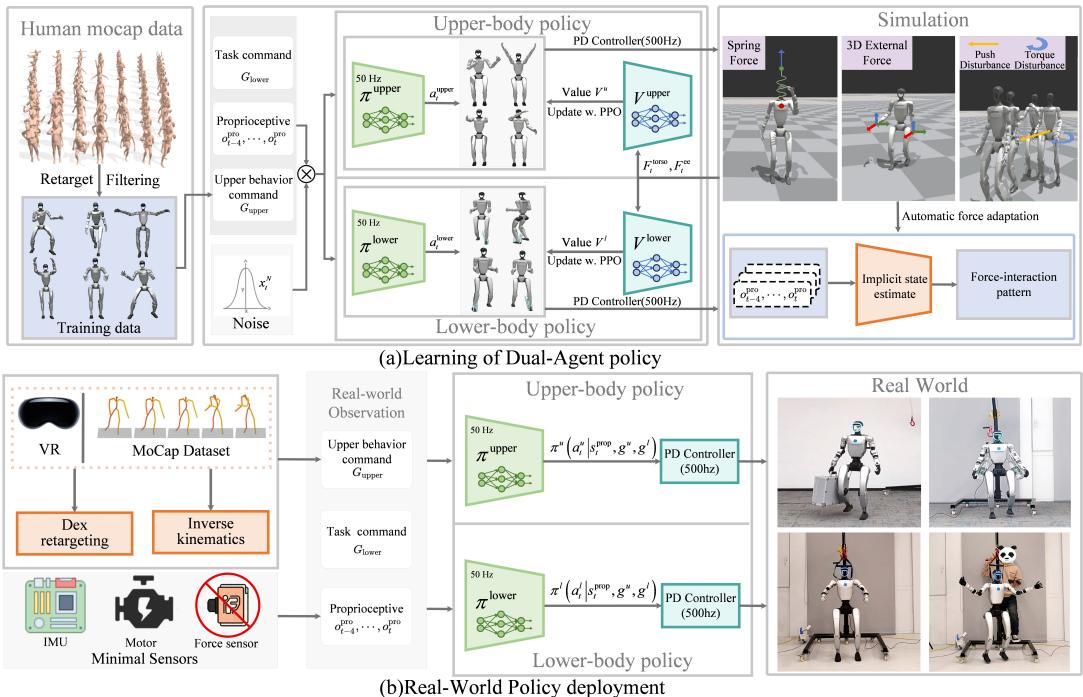
图:HAFO 双智能体力自适应框架。(a) 策略训练——上下身解耦的双智能体 RL,引入多种显式动力学扰动;(b) 策略部署——基于遥操作的人形机器人控制系统。[Dong2025]
当前大多数学习型力控方法在温和的力扰动(<70 N,准静态)下进行训练和评估。HAFO [Dong2025] 将力自适应的边界推向了极端工况。
HAFO 采用双智能体架构:下层策略负责鲁棒运动(速度命令驱动),上层策略负责精确的上肢操作(参考轨迹跟踪)。两者共享状态空间以保持协调。关键技术创新是使用虚拟弹簧-阻尼器系统显式建模外部拉力:
通过逐步调节骨盆的期望位置
实验结果展示了该框架的鲁棒性:(1) 每只手 30 N 外力下保持上肢运动跟踪误差 0.41 rad vs 基线 0.74 rad;(2) 横向 250 N 推力(0.2 s 脉冲)下快速恢复平衡;(3) 首次实现绳索悬挂状态下的人形机器人稳定控制——策略自主完成地面运动与悬挂状态之间的切换,无需显式状态机。这一能力对人形机器人在高空作业等危险环境中的应用具有先导意义。
FALCON [Zhang2025] 在移动操作方向上推进了类似目标:单一策略在施加 60 N 末端力的同时保持行走稳定。力反馈对平衡维持至关重要——消融实验显示,无力估计模块时,机器人在大力接触下发生倾覆。
6.2 模型方法与学习方法的完整光谱
将本综述中所有方法按"模型驱动 vs 数据驱动"维度排列,可以看到一条从纯模型到纯学习的完整光谱:
- 纯模型端:SEIKO(QP,500 Hz,准静态)→ 自适应力控 MPC(L1 + NMPC,200 Hz)→ 全身逆动力学 MPC(扭矩级优化,80 Hz,Fatrop 求解器 [Molnar2025])
- 混合端:Opt2Skill(轨迹优化生成参考 + IL 蒸馏为实时策略 [Liu2024])
- 纯学习端:Portela(二值切换)→ Zhi(统一方程)→ FACET(阻抗参考)→ SoftMimic(IK 增强学习)→ CHIP(在线扰动,即插即用)
一个关键的观察是:目前不存在成功的"模型预测 + 学习残差"混合方案用于力控。即,没有人将模型预测控制(提供约束满足和长时域规划)与学习残差策略(处理模型不确定性和非结构化环境)结合起来处理力位混合控制。考虑到两个端点各自的局限——模型方法受限于准静态假设和已知接触序列,学习方法受限于 ~5–10 N 的力估计精度——这一空白代表了一个高价值的研究机会。
7. 挑战与展望
综合上述 16 篇论文的集体研究发现,以下挑战构成了未来 2–3 年的研究前沿。
已识别的研究空白
-
多点力协调: SixthSense [Chen2026] 已将多点力估计推进到零样本泛化阶段,但多点力的全身协调分配优化仍是开放问题。需要同时用身体支撑、手臂推门的场景——多点力估计 + 全身力分配优化——尚无完整方案。Zhi 等人 [Zhi2025] 和 SEIKO [Rouxel2024] 均将此列为明确的未来工作方向。
-
全三维力/力矩建模: QuietWalk 只建模法向 GRF 分量。大多数 RL 方法只跟踪笛卡尔 3D 力。SixthSense 的六维力场是该方向的重要突破,但其力矩精度(17–35° 方向误差)仍有较大提升空间。切向摩擦力、力矩——对开门、拧螺丝等任务至关重要——有待更深入集成到学习型力控框架中。
-
统一评测基准: 每篇论文自定任务、自定指标(擦拭成功率、力误差 N、降噪 dBA)。该领域迫切需要标准化的力位控制 benchmark——类似 ImageNet 之于计算机视觉的作用。
-
安全保证: FACET/SoftMimic/CHIP 的柔顺调节是经验性的。机器人仍可能在策略估计失败时施加危险力量。形式化的力边界和无源性保证——尤其是在人机物理交互场景中——是部署的前提条件。
-
高频力控: 50 Hz 控制环过滤了 >100 Hz 的冲击瞬态。精密装配、抛光等需要高频力调制的应用目前不可行。
-
力感知长时域规划: 所有当前方法都是反应式的——估计力 → 立即补偿。没有任何工作将力估计集成到长时域模型预测控制中 [Molnar2025] 的逆动力学 MPC 为这一融合提供了最接近的基础,但其末端力约束目前是开环命令而非估计反馈。
最令人兴奋的融合方向
我们认为,未来 2–3 年最有前景的方向是物理信息力估计与学习型全身控制的深度融合。具体而言:
- 力估计层:采用 QuietWalk 式的 PINN、ABD-NET 式的动力学结构化网络、或 SixthSense 式的 CFM 生成式推断,分别提供
- 控制层:采用 Zhi/FACET/CHIP 式的统一阻抗框架,将力估计转化为连续柔顺调节和全身协调
- 规划层:将上述闭环力估计集成到逆动力学 MPC 框架中,实现力感知的长时域预测控制
这三个层次的集成,将使人形机器人能够在非结构化人类环境中安全、精确、自主地完成接触密集型任务——从擦拭桌面到协助搬运,从而真正走入人类的工作和生活空间。
参考文献
- [Raibert1981] Raibert, M.H. & Craig, J.J. (1981). Hybrid Position/Force Control of Manipulators. ASME Journal of Dynamic Systems, Measurement, and Control.
- [Hogan1984] Hogan, N. (1984). Impedance Control: An Approach to Manipulation. American Control Conference.
- [Kajita2010] Kajita, S. et al. (2010). Biped Walking Stabilization Based on Linear Inverted Pendulum Tracking. IEEE/RSJ IROS.
- [Murooka2022] Murooka, M., Morisawa, M., & Kanehiro, F. (2022). Centroidal Trajectory Generation and Stabilization Based on Preview Control for Humanoid Multi-Contact Motion. IEEE RA-L.
- [Portela2024] Portela, T., Margolis, G.B., Ji, Y., & Agrawal, P. (2024). Learning Force Control for Legged Manipulation. CoRL 2024. arXiv:2405.01402.
- [Zhi2025] Zhi, P., Li, P., Yin, J., Jia, B., & Huang, S. (2025). Learning a Unified Policy for Position and Force Control in Legged Loco-Manipulation. CoRL 2025. arXiv:2505.20829.
- [Xu2025] Xu, B., Weng, H., Lu, Q., Gao, Y., & Xu, H. (2025). FACET: Force-Adaptive Control via Impedance Reference Tracking for Legged Robots. arXiv:2505.06883.
- [Rouxel2024] Rouxel, Q., Ivaldi, S., & Mouret, J.-B. (2024). Multi-Contact Whole-Body Force Control for Position-Controlled Robots. IEEE RA-L. arXiv:2312.16465.
- [Hu2026] Hu, H., Feng, L., Chen, S., et al. (2026). QuietWalk: Physics-Informed RL for GRF-Aware Humanoid Locomotion Under Diverse Footwear. arXiv:2604.23702.
- [Shin2026] Shin, S., Ren, K., Xiong, X., & Hanna, J.P. (2026). Articulated-Body Dynamics Network: Dynamics-Grounded Prior for Robot Learning. arXiv:2603.19078.
- [Margolis2025] Margolis, G.B., Wang, M., Fey, N., & Agrawal, P. (2025). SoftMimic: Learning Compliant Whole-body Control from Examples. arXiv:2510.17792.
- [Chen2025] Chen, S., Cao, Z., Luo, Z., et al. (2025). CHIP: Adaptive Compliance for Humanoid Control through Hindsight Perturbation. arXiv:2512.14689.
- [Cao2025] Cao, Z., Nie, B., Zhang, Y., & Gao, Y. (2025). Minimizing Acoustic Noise: Enhancing Quiet Locomotion for Quadruped Robots in Indoor Applications. arXiv:2506.23114.
- [Dong2025] Dong, C., Xu, H., Feng, W., et al. (2025). HAFO: A Force-Adaptive Control Framework for Humanoid Robots in Intense Interaction Environments. arXiv:2511.20275.
- [Zhang2025] Zhang, Y., Yuan, Y., Gurunath, P., et al. (2025). FALCON: Learning Force-Adaptive Humanoid Loco-Manipulation. arXiv:2505.06776.
- [Molnar2025] Molnar, L., Cheng, J., Fadini, G., et al. (2025). Whole-Body Inverse Dynamics MPC for Legged Loco-Manipulation. arXiv:2511.19709.
- [Liu2024] Liu, F., Gu, Z., Cai, Y., et al. (2024). Opt2Skill: Imitating Dynamically-feasible Whole-Body Trajectories for Versatile Humanoid Loco-Manipulation. arXiv:2409.20514.
- [Sombolestan2023] Sombolestan, M. & Nguyen, Q. (2023). Adaptive Force-Based Control of Dynamic Legged Locomotion over Uneven Terrain. IEEE/RSJ IROS. arXiv:2307.04030.
- [Murooka2025] Murooka, M., Fukumitsu, K., Hamze, M., et al. (2025). Whole-body Multi-contact Motion Control for Humanoid Robots Based on Distributed Tactile Sensors. arXiv:2505.19580.
- [Chen2026] Chen, X., Xu, X., Ning, Y., Shi, L., Yu, J., Zhang, Y., Qian, S., Xiang, L., Chen, J., Wan, Y., & Zhang, H. (2026). SixthSense: Task-Agnostic Proprioception-Only Whole-Body Wrench Estimation for Humanoids. arXiv.
- [Haddadin2017] Haddadin, S., De Luca, A., & Albu-Schäffer, A. (2017). Robot Collisions: A Survey on Detection, Isolation, and Identification. IEEE Transactions on Robotics, 33(6):1292–1312.
- [Manuelli2016] Manuelli, L. & Tedrake, R. (2016). Localizing External Contact Using Proprioceptive Sensors: The Contact Particle Filter. IEEE/RSJ IROS.
字数统计: ~5500 字(含参考文献) · 引用论文: 16 篇 · 覆盖时间范围: 1981–2026