vMF分布

读一篇关于Zero-Shot的论文(Zero-Shot Adaptation of Behavioral Foundation Models to Unseen Dynamics)
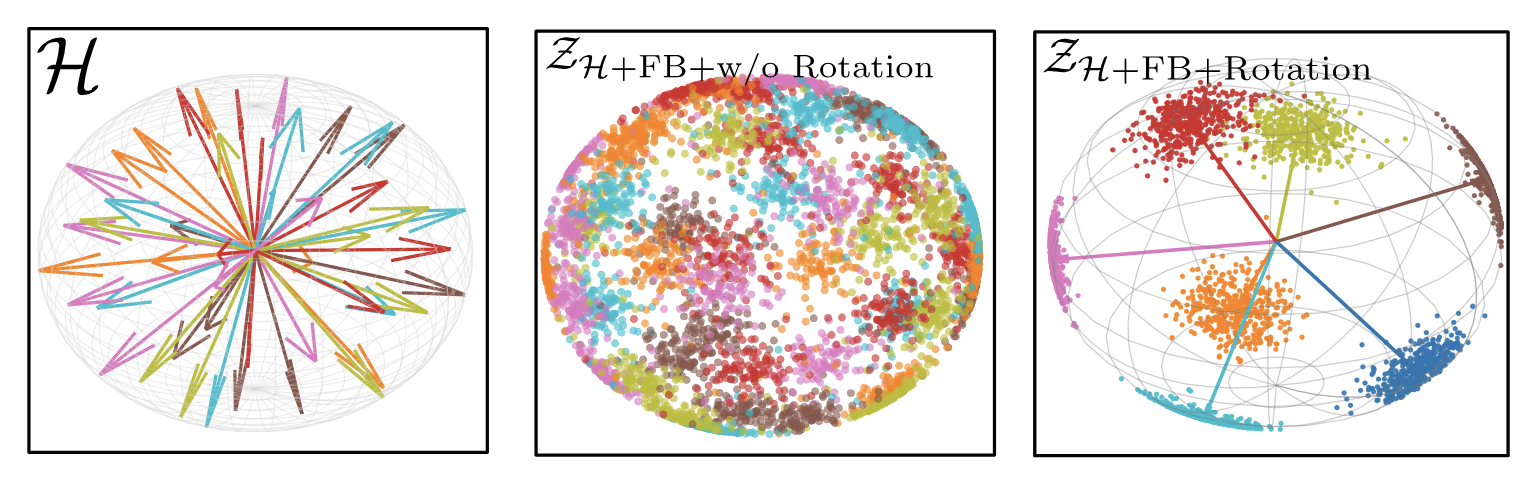
其中对于RL任务和RL动力学使用不同的latent表示
将动力学latent的h向量作为聚类中心,在其周围采样任务latent向量z,可以得到在task空间中不同动力学的z向量的聚类分布
如下图所示
这里的latent空间使用归一化的超球面,在球面上使用了一种vMF分布作为z的采样分布
这篇笔记是vMF分布的学习笔记
alt text

从高斯分布到 vMF 分布

方向统计(directional statistics)研究的是落在单位球面上的数据——罗盘读数、光的入射方向、归一化词向量、蛋白质主链的扭转角等等。这些数据没法用普通高斯直接建模,因为高斯定义在整个 Rp 上。本文从一维高斯出发,逐步过渡到方向统计中最核心的分布:von Mises–Fisher(vMF)分布。


01 · 一维高斯分布

从一维高斯分布密度函数开始讨论:

(1.1)f(x)=12πσexp(−(x−μ)22σ2)

把指数里的平方展开:

(1.2)−(x−μ)22σ2=μσ2x−x22σ2−μ22σ2

最后一项与 x 无关,可以吸收进归一化常数。于是高斯的"骨架"只剩两块:一个关于 x 的线性项,和一个二次项。

(1.3)f(x)∝exp(μσ2x−x22σ2)

线性项 μσ2x 决定分布的位置;二次项 −x22σ2 决定分布的形状。但是球面上没有二次项的位置——这正是 vMF 比高斯简单的原因。

一维高斯(密度曲线 + 实时采样)

一维高斯分布

拖动滑块观察 μ 平移曲线、 σ 改变胖瘦。浅色柱状图是从该分布实时采样得到的直方图,与理论曲线始终吻合。


02 · 多元各向同性高斯

把标量 x 换成 p 维向量 x∈Rp ,协方差取各向同性 σ2I :

(2.1)N(x;μ,σ2I)=(2πσ2)−p/2exp(−∥x−μ∥22σ2)

展开欧氏距离的平方:

(2.2)∥x−μ∥2=∥x∥2−2μ⊤x+∥μ∥2

代回指数部分:

(2.3)−∥x−μ∥22σ2=μ⊤xσ2⏟线性项−∥x∥22σ2⏟二次项−∥μ∥22σ2

于是密度可以简写为:

(2.4)N(x)∝exp(μ⊤xσ2−∥x∥22σ2)

KeyPoint

μ⊤x 衡量的是 x 在均值方向上的投影长度。这一项让密度沿着 μ 的方向增长;而 −∥x∥2/(2σ2) 把概率质量拉回原点附近,防止它跑到无穷远。


03 · 分布归一化到单位球面上

现在施加约束:所有数据点都落在单位球面上,即 x∈Sp−1 ,满足 ∥x∥=1 。

代入 ∥x∥2=1 ,那个二次项立刻变成了常数:

(3.1)−∥x∥22σ2=−12σ2=常数

常数可以整体并入归一化因子。于是只剩下线性项:

(3.2)f(x)∝exp(μ⊤xσ2)

把均值向量拆成方向与长度: μ=∥μ∥⋅μ^ ,其中 ∥μ^∥=1 。则:

(3.3)μ⊤xσ2=∥μ∥σ2μ^⊤x=κμ^⊤x

两个参数的物理含义
κ=∥μ∥/σ2 称为浓度参数(concentration)——方差越小、均值越长,分布就越集中在 μ^ 附近。
μ^ 是平均方向,落在单位球面上。

至此我们已经"猜"出了 vMF 的函数形式:

(3.4)f(x)∝exp(κμ⊤x)

剩下的工作只有一件:算出归一化常数。


04 · von Mises–Fisher 分布

设 x∈Sp−1⊂Rp ,平均方向 μ∈Sp−1 ,浓度 κ≥0 :

(4.1)f(x;μ,κ)=Cp(κ)exp(κμ⊤x)

归一化常数由修正贝塞尔函数 Iν 给出:

(4.2)Cp(κ)=κp/2−1(2π)p/2Ip/2−1(κ)

为什么是这个形式?

核心是计算这个积分。取 μ 指向北极,则 μ⊤x=cos⁡θ :

(4.3)∫Sp−1eκμ⊤xdσ(x)=Ωp−1∫0πeκcos⁡θsinp−2⁡θdθ

其中 Ωp−1=2πp/2/Γ(p/2) 是单位球面的总表面积。该积分有闭式解:

(4.4)∫Sp−1eκμ⊤xdσ(x)=(2π)p/2κ1−p/2Ip/2−1(κ)

取倒数,就得到了 Cp(κ) 。 ◼

最常用的特例: p=3

三维球面 S2 是可视化与工程中最常见的场景。用到半整数阶贝塞尔函数的初等表达式:

(4.5)I1/2(κ)=2πκsinh⁡κ

代入 p=3 :

(4.6)C3(κ)=κ1/2(2π)3/2I1/2(κ)=κ4πsinh⁡κ

于是三维球面上的 vMF 密度非常干净:

(4.7)f(x;μ,κ)=κ4πsinh⁡κexp(κμ⊤x),x∈S2

极限行为
κ→0 时 sinh⁡κ≈κ ,于是 C3→1/(4π) ——恰好是球面上的均匀分布。
κ→∞ 时密度坍缩为位于 μ 处的 Dirac δ 函数。

S2 上的 vMF 分布

S² 上的 vMF 分布

下方球面上的粒子服从 vMF(μ,κ) 。拖动球体可旋转视角;增大 κ 观察粒子如何从均匀散布收拢成一个球冠;改变 θμ,ϕμ 观察整个球冠如何迁移。


05 · 正态分布到球面的投影

知道了高斯和 vMF分布的定义。所以它们之间到底是怎么连起来的?

答案是:把高斯样本归一化到单位长度。设 y∼N(μ,σ2I) 是 Rp 中的高斯向量,令

(5.1)x=y∥y∥∈Sp−1

则 x 服从的分布称为投影正态分布(projected normal),其密度为:

(5.2)f(x;μ,σ2)∝∫0∞rp−1exp(−∥rx−μ∥22σ2)dr

把范数展开, r 的依赖关系变得清晰:

(5.3)∥rx−μ∥2=r2−2r(μ⊤x)+∥μ∥2

在各向同性的情形下(协方差为 σ2I ),对 r 积分后所有与 x 相关的部分只剩下 exp(∥μ∥μ^⊤x/σ2) 。于是:

(5.4)f(x;μ,σ2)=fvMF(x;μ^,κ),κ=∥μ∥σ2

核心结论
对各向同性高斯做径向归一化,得到的恰好是 vMF 分布。反过来,vMF 也可以看作"定义在球面上的各向同性高斯"。两个看似无关的分布,其实只差一次归一化。

几何直觉

想象 R3 中一个以 μ 为中心的高斯云。现在把每个点沿着从原点出发的射线,滑到单位球面上——方向不变,只改半径。原本散布在空间中的云,就"糊"到了球面上,形成一团集中在 μ 方向的光斑。

云越瘦( σ 越小)、中心离原点越远( ∥μ∥ 越大),光斑就越紧凑——这正是 κ=∥μ∥/σ2 的含义。

高斯 → vMF 的连续过渡演示

高斯 → vMF 的连续过渡

初始状态( t=0 )是 R3 中的各向同性高斯云,用琥珀色表示;拖动过渡滑块或打开自动播放,粒子会沿径向滑到球面上( t=1 ),颜色也逐渐变为青色——那就是 vMF 分布。

拖动 σ 滑块可以改变高斯的胖瘦,从而改变最终 vMF 的 κ 。注意观察: σ 越小,最终球面上的光斑越集中。


06 · 采样:Wood 算法

要在球面上生成服从 vMF 的点,关键是利用旋转不变性:先在 z 轴方向采样,再整体旋转到 μ 。

第 1 步:采样极角余弦 ω=cos⁡θ

在 S2 上, ω 的边缘密度正比于 eκω (面积元中的 sin⁡θ 因子在 p=3 时恰好被抵消)。累计分布函数为:

(6.1)F(ω)=eκω−e−κeκ−e−κ

令 F(ω)=u , u∼U(0,1) ,反解得到:

(6.2)ω=1+1κln(u+(1−u)e−2κ)

数值稳定性
当 κ 较大时,直接计算 e2κ 会溢出。上式把指数写成了 e−2κ ,在 κ→∞ 时自动退化为 ω≈1+ln⁡(u)/κ ,全程无溢出。

第 2 步:采样方位角并组装

取 φ∼U(0,2π) ,令 s=1−ω2 :

(6.3)x0=(scos⁡φ,ssin⁡φ,ω)

第 3 步:旋转到 μ

构造一组以 μ 为第三轴的正交基 (e1,e2,μ) ,输出:

(6.4)x=x0,1e1+x0,2e2+x0,3μ

07 · 重要性质与估计

均值合向量长度

vMF 的期望形式非常简洁——方向就是 μ ,长度只依赖 κ :

(7.1)E[x]=Ap(κ)μ,Ap(κ)=Ip/2(κ)Ip/2−1(κ)

在 p=3 时,它化为你可能见过的朗之万函数形式:

(7.2)A3(κ)=coth⁡κ−1κ

它从 0 单调增长到 1 : κ=0 时方向完全随机, κ→∞ 时所有点都指向 μ 。

参数总结

参数 取值 含义
μ Sp−1 平均方向,单位向量
κ [0,∞) 浓度;越大越集中
κ=0 — 球面上的均匀分布
κ→∞ — 退化到点 μ
p=2 — 圆周 vM 分布, C2=1/(2πI0(κ))
p=3 — C3=κ/(4πsinh⁡κ)

最大似然估计

给定样本 {x1,…,xn} ,对数似然为:

(7.3)ℓ(μ,κ)=nln⁡Cp(κ)+κμ⊤(∑i=1nxi)

对 μ 求导立刻得到: μ^ 就是样本合向量的方向,即

(7.4)μ^=∑ixi‖∑ixi‖

而 κ 由方程 Ap(κ^)=∥∑xi∥/n 隐式确定——没有闭式解,需要数值求解(牛顿法通常几轮就收敛)。


08 · Summary

各向同性高斯N(x;μ,σ2I)→展开指数→施加约束∥x∥=1→二次项变成常数→只剩exp⁡(κμ⊤x)→补上球面归一化常数→vMF 分布

球面上的各向同性高斯(投影正态)与 vMF 是等价的。因为对球面上的点,高斯密度中的 ∥x∥2=1 是常数;投影正态的二次型 x⊤Σ−1x 在 Σ=σ2I 时也退化成常数。两者给出完全相同的分布族。

这也解释了为什么 vMF 是方向统计中当之无愧的"高斯":它简单、单峰、有共轭先验、有高效采样算法,并且在 κ 的两个极端分别覆盖了均匀分布与确定性方向。