副标题: 四篇范式革新论文如何重新定义人类动作到机器人行为的桥梁
摘要
长期以来,运动重定向(Motion Retargeting)——把人类动作捕捉数据映射到机器人身体上的过程——一直被当作一个不起眼的预处理环节。研究者写一个简单的逆运动学求解器,把人的骨架缩放到机器人的尺寸,剩下的瑕疵就交给强化学习策略去慢慢消化。然而,2025至2026年间发表的四篇论文彻底改变了这一看法。本文系统梳理了四种思路迥异的重定向方法:基于优化的 GMR、物理感知的 ReActor、保持交互关系的 OmniRetarget,以及基于学习的 NMR,并把它们放进由 18 篇相关文献构成的更大图景中加以审视。我们将看到,运动重定向已经从流程末端的配角,变成了人形机器人运动智能的根基:重定向做好了,后续每一步都更轻松;做差了,再多的强化学习也难以完全补救。
一、被忽视的瓶颈:运动重定向为何骤然成为焦点
人形机器人正在以前所未有的规模走进工厂、家庭和实验室。从 Unitree G1 到 Tesla Optimus,它们都需要掌握大量复杂的全身运动技能——行走、跑步、跳舞、搬运物体、攀爬。而获取这些技能最高效的途径之一,就是从人类演示中学习。
标准的处理流程是这样的:人类动作捕捉(MoCap)→ 运动重定向 → 强化学习跟踪策略训练 → 仿真到现实(Sim-to-Real)部署。在这条链路中,重定向是把人类 SMPL 骨骼动画转化为机器人关节指令的关键一环。
然而,传统重定向方法存在明显缺陷。PHC [Luo2023] 通过拟合 SMPL 模型再用梯度下降逆运动学(IK)求解;ProtoMotions 则采用全局轴向缩放加微分 IK。这些方法虽然简单,却会引入三类破坏性的伪影:
- 地面穿透(Ground Penetration):机器人脚部陷入地面以下高达60厘米
- 自相交(Self-Penetration):肢体穿模,腿部互相穿插
- 关节跳变(Joint Jumps):关节值出现不连续的突然跳跃
以往的应对办法是"以工程量取胜"——靠大量的奖励函数设计(reward engineering)和域随机化(domain randomization),逼着下游强化学习策略硬生生学会补偿这些伪影。OmniH2O [He2024]、ExBody2 [Ji2025]、HOVER [He2025] 等先进系统都在不同程度上依赖这套做法。
GMR 的对照实验。 Araujo 等人 [Araujo2025] 借助 BeyondMimic 框架设计了一个干净的对照实验:他们刻意关掉奖励调参和域随机化,只更换重定向方法,再观察强化学习策略的表现。结果很说明问题:
- 在大多数日常动作上,各种重定向方法都能达到 98% 以上的成功率;
- 但在两段 2 分钟长的舞蹈序列上,PHC 的成功率直接跌到 0%(地面穿透深达 60 厘米),而 GMR 和 ProtoMotions 仍有 99–100%;
- 在 "Run (stop & go)" 动作上,PHC 只有 17–74% 的成功率,GMR 则达到 91–100%。
"我们的假设是,只要在奖励函数和域随机化上投入足够的工程,重定向带来的伪影大多可以被缓解甚至消除。然而一旦撤掉这些工程努力,重定向本身的质量就起决定性作用。" — [Araujo2025]
这个实验点明了一个关键事实:重定向质量是制约下游策略性能的首要瓶颈。正是这一发现,为后续几种新思路提供了出发点。
二、GMR: 优化与缩放的艺术
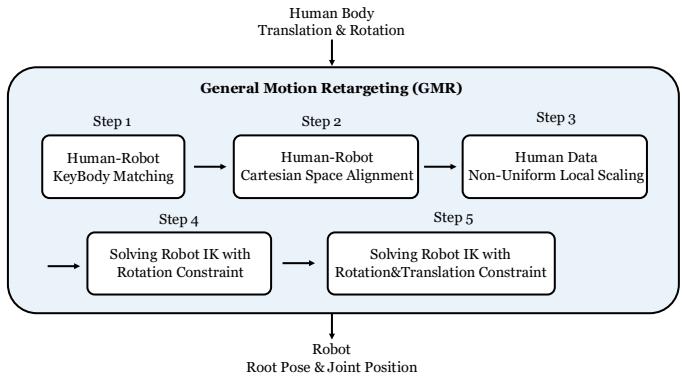
图:GMR 的五步重定向流程 [Araujo2025]
GMR(General Motion Retargeting)[Araujo2025] 的核心贡献不在于提出全新的数学框架,而在于把优化这件事做到位。整个方法分为五步:
第一步:人体—机器人关键部位映射。 用户指定源人体骨骼与目标机器人骨骼之间的对应关系(躯干对躯干,头对头,手对手等)。
第二步:静止姿态对齐。 在零姿态(T-pose)下对齐人体与机器人的朝向,消除"内八脚"之类的伪影。
第三步:非均匀局部缩放(核心创新)。 这是 GMR 与其他方法最关键的差别。传统方法(PHC、ProtoMotions)采用全局均匀缩放,即把整副人体骨架按同一比例放大或缩小;GMR 则为每个身体部位赋予独立的缩放因子
这里的关键设计是:根部平移采用统一缩放(
第四、五步:两阶段 IK 优化。 第一阶段(式 4)只优化末端执行器的位置和所有身体的朝向,避免约束过密而陷入局部极小;第二阶段(式 6)在第一阶段的解之上,加入所有关键部位的位置约束做精细调整。
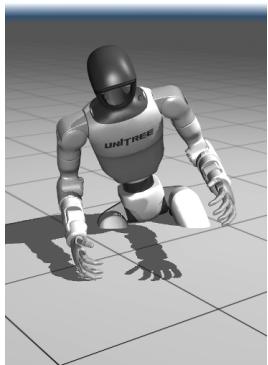
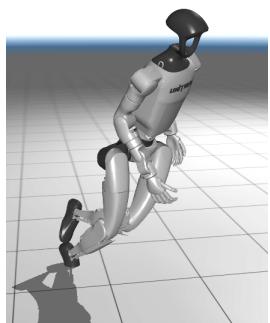
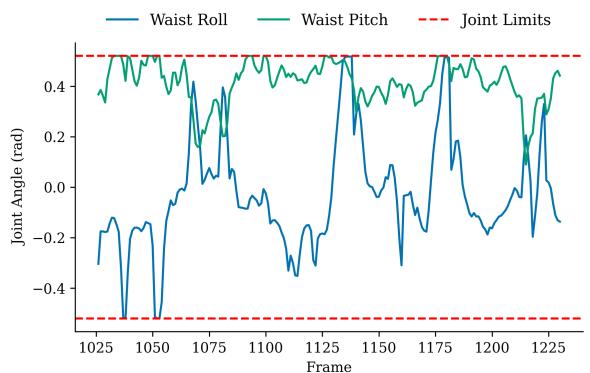
图:三种典型重定向伪影 [Araujo2025]:(a) PHC的地面穿透("Dance 1",左),(b) ProtoMotions的自相交("Run (stop & go)",中),(c) GMR的腰部关节跳变("Dance 5",右)
实验结果。 在 21 段测试序列上,GMR 的全局 MPBPE 中位数为 91.2 mm,接近闭源 Unitree 方案的 73.4 mm,明显优于 PHC 的 111.9 mm 和 ProtoMotions 的 101.9 mm。用户研究(N=20)也表明,GMR 在还原源动作方面胜过现有开源方案,已接近闭源方案的水准。
但 GMR 仍有局限。 它偶尔会产生关节跳变("Dance 5" 的腰部问题使仿真到仿真的成功率只剩 51%),需要针对具体动作单独调整优化权重。更根本的是,它始终停留在纯运动学空间——忽略了物理约束、物体交互以及环境中的丰富信息。这就引出了下一种思路。
三、ReActor :物理仿真参与的双层优化重定向
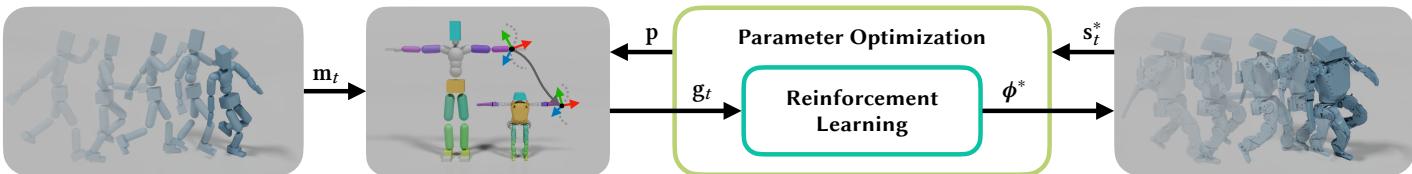
图:ReActor的双层优化框架 [Muller2026]
ReActor [Muller2026] 带来了一个大胆的视角转变:重定向就应该在物理模拟器内部完成。既然物理模拟器天生就能保证接触力、动力学和平衡的正确性,那为什么不在重定向阶段直接用上它,非要等到运动学优化之后再靠强化学习来补救呢?
双层优化框架。 ReActor 把重定向建模为一个双层优化(bilevel optimization)问题:
- 上层:优化重定向参数
- 下层:用 PPO 训练强化学习策略
精妙之处:绕开隐式微分。 双层优化的计算瓶颈,在于下层最优解对上层参数的梯度
也就是假设:最优状态轨迹对参考运动变化的敏感度,可以近似为一个标量
这个近似跳过了代价高昂的强化学习梯度回传,让整个双层优化变得切实可行。
稀疏对应。 用户只需在标准姿态(T-pose)下指定少量语义上的刚体对应关系——比如"头对头、手对手、脚对脚"。系统会自动算出全局缩放和标准变换,全程无需手动调参。
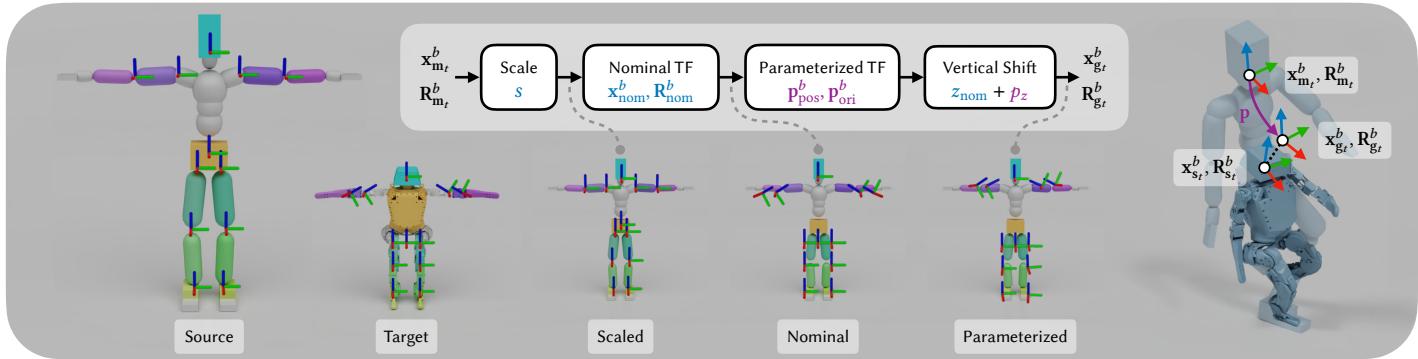
图:ReActor的重定向参数化 [Muller2026]
实验结果。 在整个 AMASS 数据集上,ReActor 做到了零地面穿透、零自相交(两种对比方法都或多或少存在伪影)。下游强化学习的成功率在 G1 上达到 97.45%、在 Lima 上达到 95.07%,均高于 GMR(89.93%、91.23%)和 OmniRetarget(95.51%、79.85%)。
更值得一提的是,ReActor 展示了跨形态重定向的能力:除了两款双足人形机器人(Unitree G1、Lima),它还成功把人类动作迁移到了四足机器人 ANYmal D 上,证明这种物理感知方法具有相当的普适性。
尚存的权衡。 外力惩罚权重的取值是一个根本性的取舍:物理约束越强,动作越真实,但高难度动作的成功率越低;约束越弱,成功率越高,物理合理性却越差。正如作者所说:
"最终,对物理上不可能的动作进行重定向仍然是一个不适定问题——我们不清楚机器人是否应该'走上虚拟楼梯',还是重定向方法应该将动作投影到地面。" — [Muller2026]
四、OmniRetarget 保留交互关系的重定向
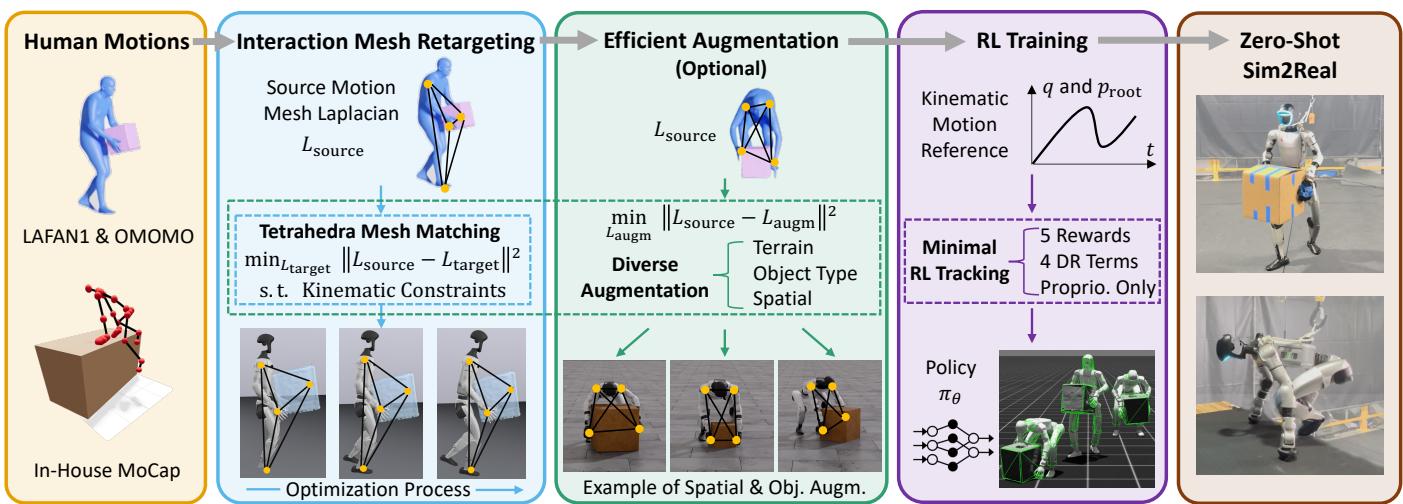
图:OmniRetarget的交互网格重定向框架 [Yang2025]
GMR 和 ReActor 解决的是同一个问题——如何把身体动作从人类映射到机器人——但它们都遗漏了一个关键维度:世界不是空的。机器人要搬箱子、爬平台、在斜坡上行走。当一个人搬起重物时,身体姿态与物体之间存在密不可分的空间关系,而这些关系在传统重定向中被全部丢弃了。
OmniRetarget [Yang2025] 是第一个系统性解决这一问题的框架。
交互网格。 其核心思想是用 Delaunay 四面体剖分,把机器人身体的关节点、物体表面采样点和地形表面采样点连成一张三维体网格。这张交互网格(interaction mesh)编码了所有元素之间的空间与接触关系。
Laplacian 形变能量。 重定向问题由此被重新表述为:在满足硬约束的前提下,最小化源(人体)交互网格与目标(机器人)交互网格之间的 Laplacian 形变能量:
其中
硬约束保证。 与采用软惩罚的 VideoMimic 等方案不同,OmniRetarget 强制满足四类硬约束:
- 碰撞避免:
- 关节限位:
- 速度限制:
- 足部粘滞:
每一帧都用序列二阶锥规划(SOCP)求解,配合信任域约束(
数据增强:一次演示,生成海量数据。 这是 OmniRetarget 的另一项关键能力。只要在物体或地形的配置空间里改变设定、重新求解优化问题,单段人类演示就能衍生出数百个变体——不同的物体位置、朝向、尺寸,以及不同的地形高度。这直接缓解了人形机器人数据稀缺这一根本瓶颈。
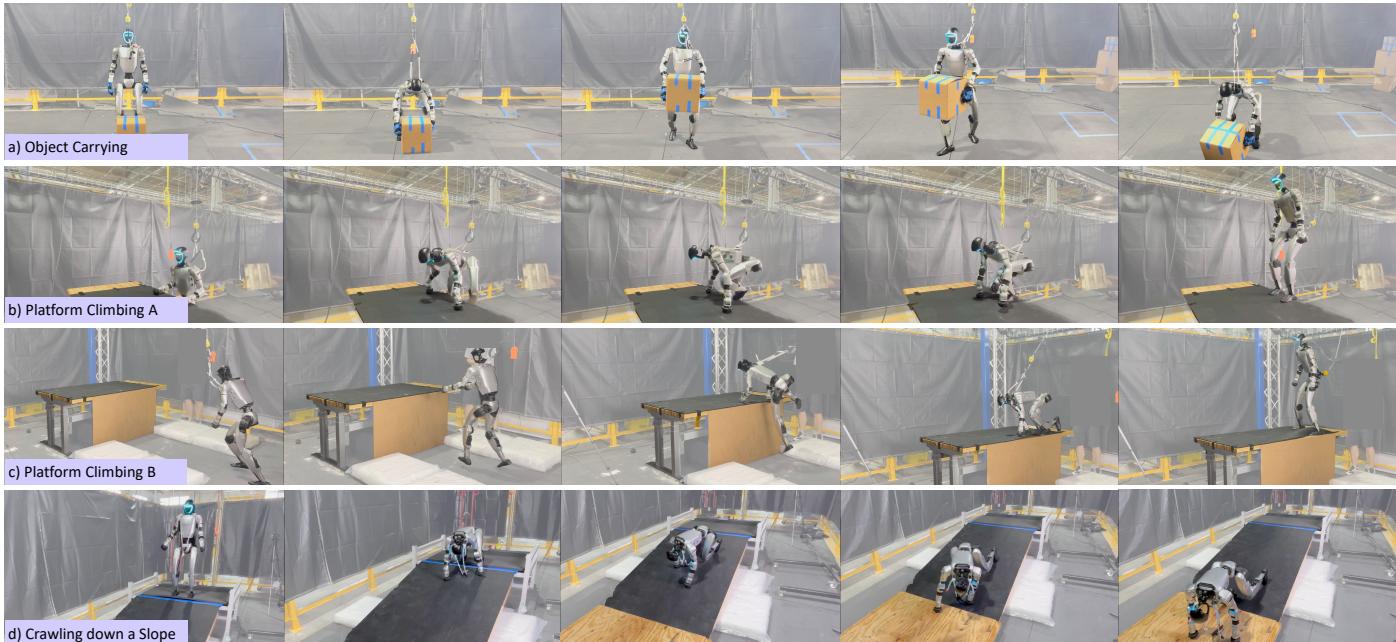
图:OmniRetarget在真实Unitree G1上的硬件实验 [Yang2025]
实验结果。 OmniRetarget 生成了超过 8 小时的重定向轨迹(OMOMO 2.78h + LAFAN1 4.6h + 自采 MoCap 1h)。下游强化学习在"机器人—物体"任务上达到 82.20% 的成功率(PHC 为 71.28%、GMR 为 50.83%、VideoMimic 仅 3.85%),在"机器人—地形"任务上达到 94.73%(PHC 为 52.63%、GMR 为 78.94%)。
最令人印象深刻的是它的零样本仿真到现实迁移:在实体 Unitree G1 上,仅凭 5 个奖励项和纯本体感知输入,就完成了 30 秒的连续跑酷(搬椅子、爬平台、跳跃、翻滚、贴墙翻转)、搬箱子、攀爬 0.9 米高台(相当于机器人身高的 70%)等一系列复杂任务。
五、NMR: 学习 or 优化 ?
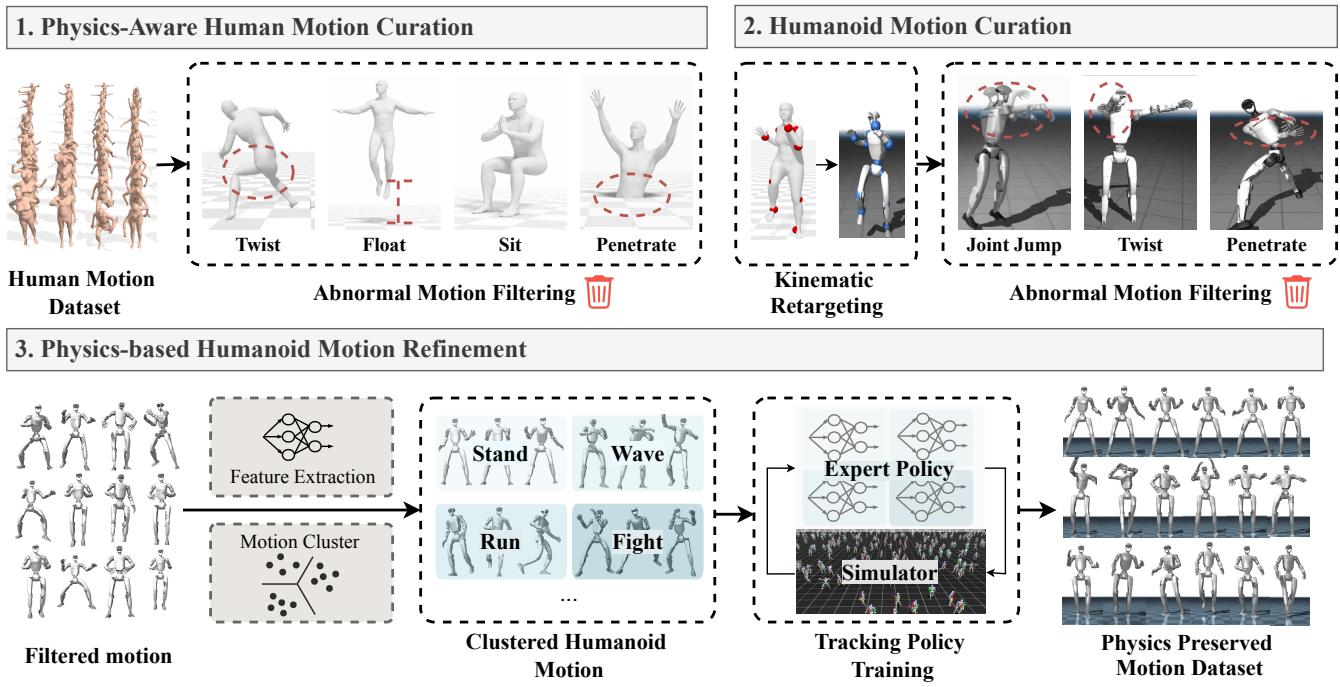
图:NMR 的 CEPR 数据构建流程 [Zhao2026]
前三篇论文都在想方设法优化重定向——或是在运动学空间里(GMR),或是在物理模拟器内(ReActor),或是在交互网格上(OmniRetarget)。NMR [Zhao2026] 则提出了一个更根本的质疑:如果问题恰恰出在"优化"本身呢?
理论突破:证明 Hessian 的非凸性。 NMR 对 GMR 这类优化目标做了严格的二阶分析。它把 SE(3) 上的姿态误差提升到李代数
其中的曲率修正项有两个互相独立的负曲率来源:(1) 前向运动学的曲率和(2) 对数映射的曲率。尤其是 SO(3) 左雅可比逆中的系数
思路转变:从优化到学习。 NMR 的核心洞见是:把重定向从"逐帧求解状态优化",重新定义为"在运动分布之间学习一个映射"。
CEPR 数据流程。 既然没有现成的标注数据,NMR 就自己造:
- 物理感知筛选:剔除原始 SMPL 数据中的异常动作(加加速度过大、质心不稳、足地接触不良);
- 运动学重定向加过滤:先用 GMR 得到初始机器人动作,再用硬阈值过滤掉不合格样本(关节超速、自相交比例 >5%、平均足部离地 >10cm);
- 聚类专家物理精修(Clustered-Expert Physics Refinement):
- 用 TMR 训练的 VAE 把所有运动序列编码到隐空间;
- 用 K-Means 做语义聚类;
- 为每个聚类训练一个大规模并行的强化学习专家策略(PPO,16384 个并行环境,对称 Actor-Critic);
- 策略收敛后采样回放,生成约 30,000 对经过物理校验的 (SMPL, 机器人) 数据对。
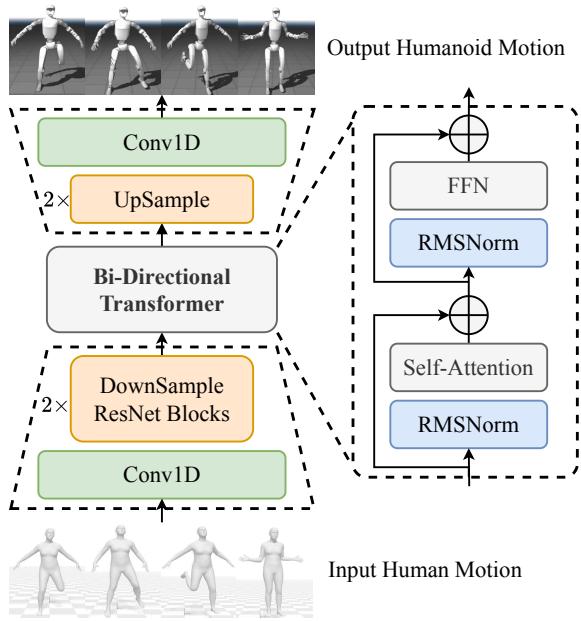
图:NMR 的 CNN-Transformer 网络架构 [Zhao2026]
网络架构。 NMR 采用非自回归的 CNN-Transformer:1D ResNet 编码器 + 全自注意力 Transformer(基于 LLaMA 架构改造,但用双向注意力代替因果注意力,让每一帧都能看到完整的时间上下文)+ 上采样解码器。训练分两阶段,遵循"先细节、后物理"的思路:先在大规模运动学数据上预训练以覆盖广泛动作,再在 CEPR 物理校验数据上微调以保证物理可行。
实验结果。 与 GMR 和 PHUMA 相比,NMR 取得了如下成绩:
- 零关节跳变(GMR 有 56 次,PHUMA 有 12 次);
- 自碰撞减少 54%(431 帧,GMR 为 947 帧);
- 关节超限减少 61%(16.80%,GMR 为 43.21%);
- 在 82 段 AMASS 测试序列上,无论短、中、长序列,NMR 的跟踪成功率都是最高的;
- 以 NMR 的参考训练的下游强化学习策略收敛更快(回合更长、奖励更高)。
更难得的是,NMR 还能隐式地抑制上游 SMPL 估计带来的噪声——同样的噪声会被优化方法原样传递下去,而 NMR 在学习过程中把它过滤掉了。
六、四篇论文在领域版图中的位置
这四篇论文并不是各自孤立的突破,而是同一股潮流的不同侧面。下面我们把它们放到更广的文献背景中来看。
重定向的设计空间。 当前的方法大致可以沿两条轴来定位:
- 何时引入物理:纯运动学(GMR、OmniRetarget)→ 数据生成阶段(NMR、SPIDER)→ 重定向过程之中(ReActor、DynaRetarget);
- 如何做决策:显式优化(GMR、OmniRetarget、ReActor)→ 学习映射(NMR、ImitationNet、AdaMorph)。
四篇核心论文恰好分布在这个设计空间的四个角落,呈现出互补而非竞争的格局。
趋同的迹象。 几处交叉引用和相互依赖值得留意:
- NMR 在其 CEPR 流程的第二步,用 GMR 来做初始的运动学重定向;
- ReActor 把 GMR 和 OmniRetarget 当作主要的对比基线;
- 四篇核心论文都以 Unitree G1 为目标平台;
- OmniRetarget 的作者中也包含 GMR 的作者 C. Karen Liu。
这些联系说明,整个领域正在围绕一套共同的问题、平台和评测标准逐渐收拢——尽管真正统一的基准还没有建立起来。
规模之争。 数据规模正成为核心竞争力:
- GMR:21 段序列,逐条重定向;
- NMR:3 万对物理校验数据;
- OmniRetarget:8 小时以上的重定向轨迹;
- SPIDER [Pan2025]:240 万帧,覆盖 9 种机器人形态。
端到端视角。 重定向的进步直接带动了整条流程的发展:
- OmniH2O [He2024] 确立了"以运动学姿态作为通用控制接口"的范式;
- ExBody2 [Ji2025] 借助师生蒸馏,实现了表现力很强的全身控制;
- HOVER [He2025] 把多种控制模式蒸馏进同一个策略——重定向后的运动正是其统一的中间表示;
- ASAP [He2025] 的残差动作模型,直接受益于更高质量的重定向参考。
走向通用的雄心。 ReActor 的四足机器人实验、AdaMorph [Zhang2026] 支持 12 种形态的统一模型、SPIDER 覆盖 9 种形态,共同指向一个宏大的目标:通用运动重定向——用一个模型、一套框架,把任意人类动作映射到任意机器人身体上。
尚未补全的环节。 灵巧手的重定向(ByteDexter 是早期尝试)、多智能体交互的重定向、实时遥操作下的延迟约束——这些问题在当前的讨论中几乎还是空白。
七、仍待解答的问题
综合这四篇论文和相关文献,可以梳理出以下几个共同的研究空白:
1. 缺乏统一基准。 各篇论文用的数据集不同(LAFAN1、AMASS、OMOMO),机器人不同(虽然都说支持 G1,但运动学参数各异),评测指标也不同(成功率、MPBPE、关节跳变次数、穿透时长、用户研究)。这个领域亟需一套类似 ImageNet 或 GLUE 的标准化评测体系。
2. 跨形态泛化。 AdaMorph [Zhang2026] 开了个好头,但真正与形态无关的重定向——用一个模型同时应对人形机器人、四足机器人乃至机械臂——还远未实现。
3. 从带噪声的感知中重定向。 四篇核心论文都假设输入是干净的 MoCap 或 SMPL。如何从单目视频、深度传感器或带明显噪声和遮挡的 VR 姿态中做重定向,仍探索不足(OKAMI 和 Direct Dynamic Retargeting 是早期尝试)。
4. 灵巧手。 四篇核心论文要么把手当作刚体,要么干脆忽略。20 自由度灵巧手的重定向,几乎是一个独立的研究方向。
5. 实时性约束。 遥操作要求重定向以 30–120 Hz 运行。GMR 的逐帧 IK 速度快但只能串行;NMR 的神经网络可以并行但依赖 GPU。目前还没有论文系统评测过推理延迟。
6. 安全与故障恢复。 当重定向产生不可行甚至危险的动作时,会发生什么?目前没有论文讨论运行时的安全监控或平稳降级。
7. 长时漂移。 GMR 表明,伪影会在 2 分钟的舞蹈序列里不断累积,最终导致 PHC 彻底失败。还没有方法专门处理超长序列(5 分钟以上)的误差累积。
8. 理论基础。 NMR 的 Hessian 分析,是第一个解释"基于优化的重定向为何会失败"的理论结果。这个领域还需要更多理论工作:收敛性保证、学习方法的样本复杂度,以及对"重定向质量"的形式化定义。
9. 超出运动学的形态差异。 人和机器人在质量分布、执行器动力学和柔顺性上都有差异。ReActor 借助物理模拟部分解决了这一问题,但执行器层面的重定向(力矩曲线、阻抗)仍是空白。
八、重定向:从"配角"到"地基"
在 2025 到 2026 这短短两年里,运动重定向完成了一次身份转变——从工程上的预处理步骤,变成了运动智能的基石。
GMR [Araujo2025] 用严谨的实验证明,重定向质量是制约下游策略性能的首要瓶颈:做好了事半功倍,做差了事倍功半。ReActor [Muller2026] 把整个问题搬进物理模拟器,让物理可行性成为"水到渠成"的结果。OmniRetarget [Yang2025] 坚持认为世界不是空的——保持与物体、地形的交互关系,正是移动操作(loco-manipulation)的关键。NMR [Zhao2026] 则在理论上证明传统优化本质非凸,在实践上用学习取代了优化。
这四种思路并非互相排斥,而是彼此补充:NMR 用 GMR 的数据来初始化,ReActor 以 GMR 和 OmniRetarget 为对比基线,而所有方法都在同一平台上评测。由此不难推测:未来的系统很可能会把学习映射(NMR 的高效推理)、物理校验(ReActor 的可行性保证)和交互感知(OmniRetarget 的空间关系保持)结合到一起,并继续建立在 GMR 所提供的优化洞见之上。
随着人形机器人以前所未有的规模进入真实世界——走进工厂、仓库、医院和家庭——运动重定向的质量,将直接决定人机交互的质量。重定向不再是"把数据丢给强化学习"之前的预处理步骤,而是支撑起人形机器人运动智能的地基。
参考文献
[Araujo2025] Araujo, J. P., Ze, Y., Xu, P., Wu, J., & Liu, C. K. (2025). Retargeting Matters: General Motion Retargeting for Humanoid Motion Tracking. arXiv:2510.02252.
[Muller2026] Muller, D., Serifi, A., Christen, S., Grandia, R., Knoop, E., & Bacher, M. (2026). ReActor: Reinforcement Learning for Physics-Aware Motion Retargeting. ACM Trans. Graph. (SIGGRAPH 2026). arXiv:2605.06593.
[Yang2025] Yang, L., Huang, X., Wu, Z., Kanazawa, A., Abbeel, P., Sferrazza, C., Liu, C. K., Duan, R., & Shi, G. (2025). OmniRetarget: Interaction-Preserving Data Generation for Humanoid Whole-Body Loco-Manipulation and Scene Interaction. arXiv:2509.26633.
[Zhao2026] Zhao, Q., Yang, K., Wang, X., Zhao, S., Lu, Y., Zhang, X., Yin, W., Shen, Q., Long, X.-X., & Cao, X. (2026). Make Tracking Easy: Neural Motion Retargeting for Humanoid Whole-body Control. arXiv:2603.22201.
[Luo2023] Luo, Z., Cao, J., Kitani, K., & Xu, W. (2023). Perpetual Humanoid Control for Real-time Simulated Avatars. ICCV 2023.
[He2024] He, T., Luo, Z., He, X., Xiao, W., Zhang, C., Zhang, W., Kitani, K., Liu, C., & Shi, G. (2024). OmniH2O: Universal and Dexterous Human-to-Humanoid Whole-Body Teleoperation and Learning. CoRL 2024.
[Ji2025] Ji, M., Peng, X., Liu, F., Li, J., Yang, G., Cheng, X., & Wang, X. (2025). ExBody2: Advanced Expressive Humanoid Whole-Body Control. arXiv:2412.13196.
[He2025a] He, T., Xiao, W., Lin, T., Luo, Z., Xu, Z., Jiang, Z., Kautz, J., Liu, C., Shi, G., Wang, X., Fan, L., & Zhu, Y. (2025). HOVER: Versatile Neural Whole-Body Controller for Humanoid Robots. ICRA 2025.
[He2025b] He, T. et al. (2025). ASAP: Aligning Simulation and Real-World Physics for Learning Agile Humanoid Whole-Body Skills. arXiv:2502.01143.
[Grandia2023] Grandia, R. et al. (2023). DOC: Differentiable Optimal Control for Retargeting.
[Zhang2026a] Zhang, H., Jin, S., Li, L., Li, J., Lin, L., He, X., & Zeng, Z. (2026). AdaMorph: Unified Motion Retargeting via Embodiment-Aware Adaptive Transformers. arXiv:2601.07284.
[Zhang2026b] Zhang, X., Haener, S. P., Madabushi, V., & Tucker, M. (2026). KDMR: Kinodynamic Motion Retargeting for Humanoid Locomotion via Multi-Contact Whole-Body Trajectory Optimization. arXiv:2603.09956.
[Pan2025] Pan, C. et al. (2025). SPIDER: Scalable Physics-Informed Dexterous Retargeting. arXiv:2511.09484.
[Dhedin2026] Dhedin, V. et al. (2026). DynaRetarget: Dynamically-Feasible Retargeting using Sampling-Based Trajectory Optimization. arXiv:2602.06827.
[Yan2023] Yan, Y., Mascaro, E. V., & Lee, D. (2023). ImitationNet: Unsupervised Human-to-Robot Motion Retargeting via Shared Latent Space. IEEE-RAS Humanoids 2023.
[Fu2024] Fu, Z., Zhao, Q., Wu, Q., Wetzstein, G., & Finn, C. (2024). HumanPlus: Humanoid Shadowing and Imitation from Humans. arXiv:2406.10454.
[Wang2024] Wang, J. et al. (2024). OKAMI: Teaching Humanoid Robots Manipulation Skills through Single Video Imitation. CoRL 2024.
[Figuera2024] Figuera, X., Park, S., & Ahn, H. (2024). MR.HuBo: Redefining Data Pairing for Motion Retargeting Leveraging a Human Body Prior. IROS 2024.
[Roux2026] Roux, C. et al. (2026). Direct Dynamic Retargeting for Humanoid Imitation Learning from Videos. arXiv:2605.23762.
[Lu2025] Lu, C. et al. (2025). Mobile-TeleVision: Predictive Motion Priors for Humanoid Whole-Body Control. ICRA 2025.
[Zhang2025] Zhang, H. et al. (2025). Natural Humanoid Robot Locomotion with Generative Motion Prior. arXiv:2503.09015.
[Chen2025] Chen, X. et al. (2025). Implicit Kinodynamic Motion Retargeting for Human-to-Humanoid Imitation Learning. arXiv:2509.15443.